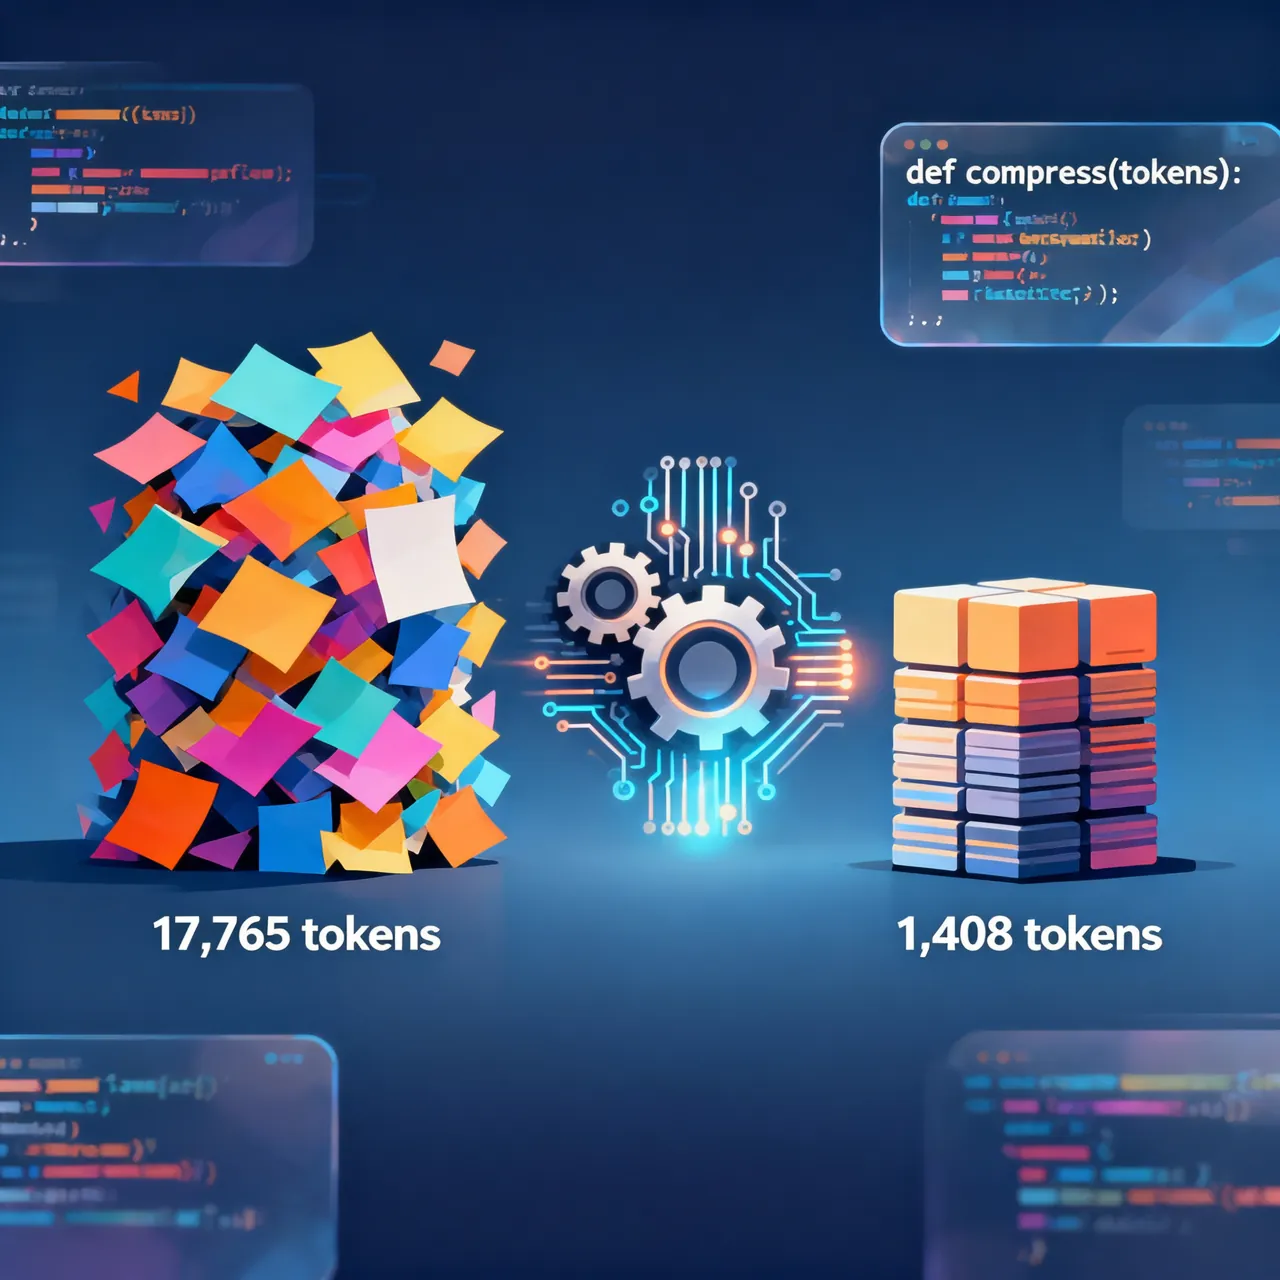
Headroom이란?
Headroom은 오픈소스 LLM 토큰 압축 레이어입니다. AI 에이전트가 읽는 모든 콘텐츠—툴 출력, 로그, RAG 검색 결과, 파일 및 대화 기록—를 LLM에 전송하기 전에 지능적으로 압축합니다.
핵심 가치: 동일한 답변을 5-40%의 토큰만으로. 매일 AI 코딩 어시스턴트(Claude Code, Cursor, Codex 등)를 많이 사용하는 개발자에게 이는 API 비용을 직접 60-95% 절감한다는 의미입니다.
왜 Headroom이 필요한가?
현대 AI 코딩 어시스턴트의 워크플로는 보통 이렇습니다:
사용자 질문 → 에이전트 코드베이스 검색 → 100개 이상 파일 스니펫 반환 →
에이전트 모든 컨텍스트 정리 → LLM으로 전송 → LLM 답변
문제는 에이전트가 보내는 컨텍스트의 대부분이 중복이라는 점입니다. 예를 들어:
- 검색 결과가 100개 코드 스니펫을 반환하지만 실제로 관련 있는 것은 5-10개뿐
- 로그 파일에 불필요한 타임스탬프와 디버그 정보가 많음
- RAG에서 검색한 문서 블록에 반복되는 접두사가 많음
Headroom은 3계층 아키텍처로 이 문제를 해결합니다:
- ContentRouter — 콘텐츠 유형(JSON, 코드, 일반 텍스트) 감지 후 최적 압축기 자동 선택
- 지능형 압축기 — SmartCrusher(JSON), CodeCompressor(AST 인식), Kompress-base(HF 모델)
- CCR(가역 압축) — 원본 데이터 로컬 저장, LLM 필요 시 온디맨드 검색
Headroom vs 다른 솔루션
| 기능 | Headroom | 네이티브 Provider 압축 | 수동 프롬프트 정제 |
|---|---|---|---|
| 토큰 절감 | 60-95% | 20-40% | 사람에 따라 다름 |
| 에이전트 간 메모리 공유 | ✅ | ❌ | ❌ |
| 가역 압축(CCR) | ✅ | ❌ | N/A |
| 무코드接入(Proxy) | ✅ | ❌ | N/A |
| 로컬 실행 | ✅ | ❌(클라우드) | ✅ |
| 다국어 지원 | Python + TS | SDK 한정 | N/A |
Headroom 설치
Headroom은 Python과 Node.js를 지원합니다. pip로 전체 기능 버전을 설치하는 것을 권장합니다.
Python 설치
# 전체 버전 설치(proxy, MCP, ML 등 모든 기능 포함)
pip install "headroom-ai[all]"

# 또는 필요 모듈만 설치
pip install "headroom-ai[proxy]"   # 프록시 모드만
pip install "headroom-ai[mcp]"     # MCP 서버만
pip install "headroom-ai[ml]"      # 머신러닝 압축 모델
요구사항: Python 3.10+
Node.js / TypeScript 설치
npm install headroom-ai
설치 확인
# 버전 및 기능 확인
headroom --version

# 성능 테스트 실행, 현재 환경의 압축 효과 확인
headroom perf
빠른 시작: 세 가지 사용 모드
Headroom은 쉬운 순서대로 세 가지接入 방식을 제공합니다:
모드 1: Wrap 명령어(가장 간단, 제로 설정)
이미 AI 코딩 어시스턴트를 사용하고 있다면, 단 한 줄 명령어로 Headroom을 활성화할 수 있습니다:
# Claude Code 래핑
headroom wrap claude

# Codex 래핑
headroom wrap codex

# Cursor 래핑
headroom wrap cursor

# Aider 래핑
headroom wrap aider

# GitHub Copilot CLI 래핑
headroom wrap copilot
실행 후 Headroom은 자동으로: 1. 로컬 프록시 서비스 시작(기본 포트 8787) 2. 해당 Agent 설정 수정하여 요청을 프록시로 라우팅 3. 설정 설명 출력,生效 여부 확인 방법 안내
예시: Claude Code 래핑
$ headroom wrap claude

✅ Headroom proxy started on port 8787
✅ Claude Code config updated

To verify, run:
  claude "What is 2+2?"

You should see compression stats in the output.
이후 claude 명령어를 사용할 때마다 요청은 먼저 Headroom을 거쳐 압축된 뒤 Anthropic API로 전송됩니다.
모드 2: Proxy 프록시 모드(무코드 변경, 모든 언어에 적합)
기존 코드를 수정하고 싶지 않거나 wrap을 지원하지 않는 도구를 사용한다면 프록시 서비스를 단독으로 시작할 수 있습니다:
# 프록시 시작, 8787 포트 리스닝
headroom proxy --port 8787
그런 다음 앱이나 Agent 설정을 수정해 API 엔드포인트를 원래 Anthropic/OpenAI 엔드포인트 대신 http://localhost:8787로 지정합니다.
예시: OpenAI 호환 클라이언트
from openai import OpenAI

# 원래 설정
# client = OpenAI(api_key="sk-...")

# Headroom 프록시 통해 사용
client = OpenAI(
    api_key="sk-...",
    base_url="http://localhost:8787/v1"  # Headroom 프록시 지정
)

response = client.chat.completions.create(
    model="gpt-4",
    messages=[{"role": "user", "content": "이 코드 설명해줘"}]
)
프록시를 거치는 모든 요청은 비즈니스 로직 수정 없이 자동으로 압축됩니다.
모드 3: Library 라이브러리 모드(가장 유연, 앱에 내장)
자체 AI 앱을 개발 중이라면 Headroom의 압축 함수를 직접 호출할 수 있습니다:
Python 예시
from headroom import compress

messages = [
    {"role": "user", "content": "이 로그 파일 분석해줘"},
    {"role": "assistant", "content": "로그 내용을 제공해주세요"},
    {"role": "user", "content": "[... 10000줄 로그 ...]"}
]

# 메시지 압축
compressed = compress(messages, model="claude-3-sonnet")

print(f"원본 토큰: {compressed.original_tokens}")
print(f"압축 후 토큰: {compressed.compressed_tokens}")
print(f"절감: {compression.savings_percent}%")

# LLM으로 전송
response = anthropic_client.messages.create(
    model="claude-3-sonnet-20240229",
    max_tokens=1024,
    messages=compressed.messages  # 압축된 메시지 사용
)
TypeScript 예시
import { compress } from 'headroom-ai';

const messages = [
  { role: 'user', content: 'Analyze this codebase' },
  { role: 'assistant', content: 'Please provide the files' },
  { role: 'user', content: '[... 50 files ...]' }
];

const compressed = await compress(messages, { model: 'gpt-4' });

console.log(`Saved ${compressed.savingsPercent}% tokens`);
핵심 기능 상세
1. 지능형 압축 알고리즘
Headroom에는 콘텐츠 유형에 따라 자동으로 선택되는 여러 압축 알고리즘이 내장되어 있습니다:
SmartCrusher — JSON 압축
구조화된 데이터(API 응답, 설정 파일, 데이터베이스 쿼리 결과) 처리 전용:
from headroom import SmartCrusher

data = {
    "users": [
        {"id": 1, "name": "Alice", "email": "alice@example.com", "created_at": "2024-01-01"},
        {"id": 2, "name": "Bob", "email": "bob@example.com", "created_at": "2024-01-02"},
        # ... 1000개 이상 레코드
    ]
}

crusher = SmartCrusher()
compressed = crusher.compress(data)

# 키워드 필드 유지, 불필요한 메타데이터 제거
# 원본: 50,000 토큰 → 압축 후: 5,000 토큰 (90% 절감)
CodeCompressor — AST 인식 코드 압축
코드 구문 트리를 이해해 핵심 구조만 유지:
from headroom import CodeCompressor

code = """
def calculate_total(items):
    '''Calculate total price with tax'''
    total = 0
    for item in items:
        if item.active:
            total += item.price * item.quantity
    tax = total * 0.08
    return total + tax
"""

compressor = CodeCompressor(language="python")
compressed = compressor.compress(code)

# 함수 시그니처, 제어 흐름, 핵심 변수 유지
# 주석, 공백, 비핵심 구현 세부사항 제거
지원 언어: Python, JavaScript, Go, Rust, Java, C++
Kompress-base — 일반 텍스트 압축
HuggingFace에서 훈련된 전용 모델로 자연어, 문서, 로그 등 처리:
# 첫 사용 시 모델 자동 다운로드(약 500MB)
headroom proxy

# 모델 캐시 위치: ~/.cache/headroom/kompress-base
2. CCR 가역 압축
CCR(Compress-Cache-Retrieve)은 Headroom의 핵심 혁신입니다: 압축된 데이터를 LLM에 전송하지만 원본 데이터는 로컬에 보관됩니다. LLM이 전체 내용을 봐야 할 경우 headroom_retrieve 도구를 호출해 가져올 수 있습니다.
워크플로:
1. Headroom 콘텐츠 압축 → LLM으로 전송
2. LLM 추가 세부사항 필요 감지 → headroom_retrieve(chunk_id) 호출
3. Headroom 로컬 캐시에서 원본 데이터 반환
4. LLM 전체 정보 획득, 추론 계속
장점: - LLM이 처음 받는 것은 압축 버전이라 토큰 사용량 적음 - 필요할 때만 전체 내용 검색, 한 번에 대량 데이터 전송 방지 - 원본 데이터 영구 손실 없음
3. 에이전트 간 메모리 공유
여러 AI 어시스턴트(Claude Code + Codex + Cursor 등)를 동시에 사용한다면 Headroom으로 압축된 컨텍스트를 공유할 수 있습니다:
# 공유 메모리 활성화
headroom wrap claude --memory
headroom wrap codex --memory
이제 Claude Code가 처리한 코드베이스 인덱스가 캐시되므로 Codex가 다시 스캔하지 않고 재사용할 수 있습니다. 대형 프로젝트에 특히 유용합니다.
4. MCP 서버 통합
Headroom은 MCP(Model Context Protocol) 서버로 실행될 수 있으며, MCP를 지원하는 모든 클라이언트가 호출할 수 있습니다:
# MCP 서버 설치
headroom mcp install

# 사용 가능한 MCP 도구:
# - headroom_compress: 임의 콘텐츠 압축
# - headroom_retrieve: 원본 데이터 검색
# - headroom_stats: 압축 통계 확인
예시: Claude Desktop에서 사용
// claude_desktop_config.json
{
  "mcpServers": {
    "headroom": {
      "command": "headroom",
      "args": ["mcp", "serve"]
    }
  }
}
실전 사례
사례 1: 코드베이스 검색 최적화
시나리오: AI 어시스턴트에 10만 줄 코드 프로젝트에서 특정 기능 구현 찾기 요청.
Headroom 미사용:
Agent 검색 → 100개 관련 파일 반환 → 모두 LLM으로 전송 →
토큰 사용량: 17,765 → 비용 높고 응답 느림
Headroom 사용:
headroom wrap claude
claude "사용자 인증 모듈 구현 찾아줘"
Agent 검색 → Headroom이 100개 파일 압축 →
토큰 사용량: 1,408 → 92% 절감
실제 테스트 데이터:
| 워크로드 | 압축 전 | 압축 후 | 절감 |
|---|---|---|---|
| 코드 검색(100개 결과) | 17,765 | 1,408 | 92% |
| SRE 사고 디버깅 | 65,694 | 5,118 | 92% |
| GitHub Issue 분류 | 54,174 | 14,761 | 73% |
| 코드베이스 탐색 | 78,502 | 41,254 | 47% |
사례 2: 다중 Agent 협업
시나리오: Claude Code로 코드 리뷰, Codex로 단위 테스트 생성, Cursor로 코드 리팩토링.
전통 방식: 각 Agent가 코드베이스를 독립적으로 스캔해야 해 토큰이 중복 소모됨.
Headroom 공유 메모리 사용:
# 1단계: Claude Code 스캔 및 캐싱
headroom wrap claude --memory
claude "src/auth/ 디렉토리 코드 품질 리뷰해줘"

# 2단계: Codex 캐시 재사용
headroom wrap codex --memory
codex "src/auth/ 단위 테스트 생성해줘"
# Codex가 Claude의 캐시된 인덱스 직접 사용, 재스캔 불필요

# 3단계: Cursor 계속 재사용
headroom wrap cursor --memory
cursor "src/auth/ 에러 핸들링 리팩토링해줘"
절감 효과: 두 번째 이후 Agent들은 초기 스캔 토큰을 40-60% 절감할 수 있습니다.
사례 3: 로그 파일 분석
시나리오: 프로덕션 환경 문제 디버깅 시 AI에 10,000줄 로그 파일 분석 요청.
from headroom import compress
import anthropic

# 로그 읽기
with open("production.log") as f:
    logs = f.read()

messages = [
    {"role": "user", "content": f"이 로그 분석해서 에러 원인 찾아줘:\n{logs}"}
]

# 압축
compressed = compress(messages, model="claude-3-sonnet")

print(f"원본: {compressed.original_tokens} 토큰")
print(f"압축 후: {compressed.compressed_tokens} 토큰")
print(f"절감: {compressed.savings_percent}%")

# 전송
client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-3-sonnet-20240229",
    max_tokens=2048,
    messages=compressed.messages
)

print(response.content[0].text)
일반적 효과: 65,694 토큰 → 5,118 토큰(92% 절감), 핵심 에러 정보는 손실되지 않음.
성능 벤치마크
Headroom은 표준 벤치마크에서 정확도를 유지합니다:
| 벤치마크 | 카테고리 | 샘플 수 | 베이스라인 정확도 | Headroom 정확도 | 차이 |
|---|---|---|---|---|---|
| GSM8K | 수학 | 100 | 0.870 | 0.870 | ±0.000 |
| TruthfulQA | 사실성 | 100 | 0.530 | 0.560 | +0.030 |
| SQuAD v2 | QA | 100 | — | 97% | 19% 압축률 |
| BFCL | 툴 호출 | 100 | — | 97% | 32% 압축률 |
결론: Headroom은 정확도를 유지하면서 상당한 토큰 절감을 실현합니다.
벤치마크 재현:
python -m headroom.evals suite --tier 1
고급 설정
CacheAligner — Provider KV 캐시 히트율 향상
CacheAligner는 프롬프트 접두사를 안정화해 Anthropic/OpenAI의 KV 캐시가 히트되도록 하여 비용을 추가로 절감합니다:
from headroom import CompressionMiddleware

# ASGI 앱에 미들웨어 추가
app.add_middleware(CompressionMiddleware)
headroom learn — 실패에서 학습
Headroom은 실패한 세션을 마이닝해 자동으로 CLAUDE.md 또는 AGENTS.md에 수정 사항을 기록할 수 있습니다:
# 학습 모드 활성화
headroom wrap claude --learn

# Claude Code가 잘못된 답변을 줄 때 Headroom은:
# 1. 실패 원인 분석
# 2. 수정 프롬프트 생성
# 3. 프로젝트의 CLAUDE.md에 기록
# 4. 다음 세션에서 자동 적용
사용자 정의 압축 전략
Pipeline을 통해 사용자 정의 압축 동작을 확장할 수 있습니다:
from headroom import PipelineExtension

class MyCustomCompressor(PipelineExtension):
    def on_input_received(self, event):
        # 입력 수신 시 사용자 정의 로직 실행
        print(f"Received {len(event.content)} bytes")

    def on_input_compressed(self, event):
        # 압축 완료 후 실행
        print(f"Compressed to {event.compressed_size} bytes")

# 확장 등록
pipeline.register(MyCustomCompressor())
자주 묻는 질문
Q1: Headroom이 답변 품질에 영향을 미치나요?
답: 아니요. 벤치마크에서 정확도가 동일하게 유지됩니다(GSM8K: 0.870 → 0.870). CCR 가역 압축으로 LLM이 언제든지 전체 내용을 검색할 수 있습니다.
Q2: 데이터 보안은 어떤가요?
답: Headroom은 완전히 로컬에서 실행되며 모든 압축, 캐싱, 저장이 사용자의 머신에서 이루어집니다. 원본 데이터는 외부 서버로 전송되지 않습니다.
Q3: 어떤 LLM Provider를 지원하나요?
답: 이론적으로 모든 Provider를 지원합니다. Headroom은 프롬프트 레벨에서 작동하기 때문입니다. 검증된 지원 목록: - Anthropic (Claude) - OpenAI (GPT-4, GPT-3.5) - AWS Bedrock - Google Gemini - 모든 OpenAI 호환 API
Q4: 압축이 지연 시간을 증가시키나요?
답: 로컬 압축은 보통 10-50ms 내에 완료되며 네트워크 요청(수백 ms~수 초)에 비해 무시할 수준입니다. 게다가 전송 토큰이 적어져 전체 응답 시간은 일반적으로 더 빨라집니다.
Q5: 개인 개발자와 팀 중 누구에게 적합한가요?
답: 둘 다 적합합니다. - 개인 개발자: 매일 AI 어시스턴트 사용, API 비용 절감 - 팀: 에이전트 간 메모리 공유로 코드베이스 재스캔 방지; 통합 압축 전략으로 비용 통제 용이
요약
Headroom은 실제 문제를 해결하는 고품질 오픈소스 도구입니다. AI 코딩 어시스턴트를重度로 사용하는 개발자에게 다음과 같은 혜택을 제공합니다:
✅ 토큰 비용 60-95% 절감 — 직접省钱
✅ 무코드接入 — headroom wrap claude 한 줄 명령어로搞定
✅ 에이전트 간 메모리 공유 — Claude, Codex, Cursor가 캐시 공유
✅ 가역 압축(CCR) — 원본 데이터 손실 없음, LLM이 온디맨드 검색 가능
✅ 로컬 실행 — 데이터 안전, 프라이버시 유출 위험 없음
팀의 월 LLM API 지출이 $100를 넘는다면 Headroom은 분명히 큰 돈을 절약해 줄 것입니다.
지금 시작하세요:
pip install "headroom-ai[all]"
headroom wrap claude  # 또는 사용하는任何 Agent
headroom perf         # 절감 효과 확인
프로젝트 주소: https://github.com/chopratejas/headroom
문서: https://headroom-docs.vercel.app/docs