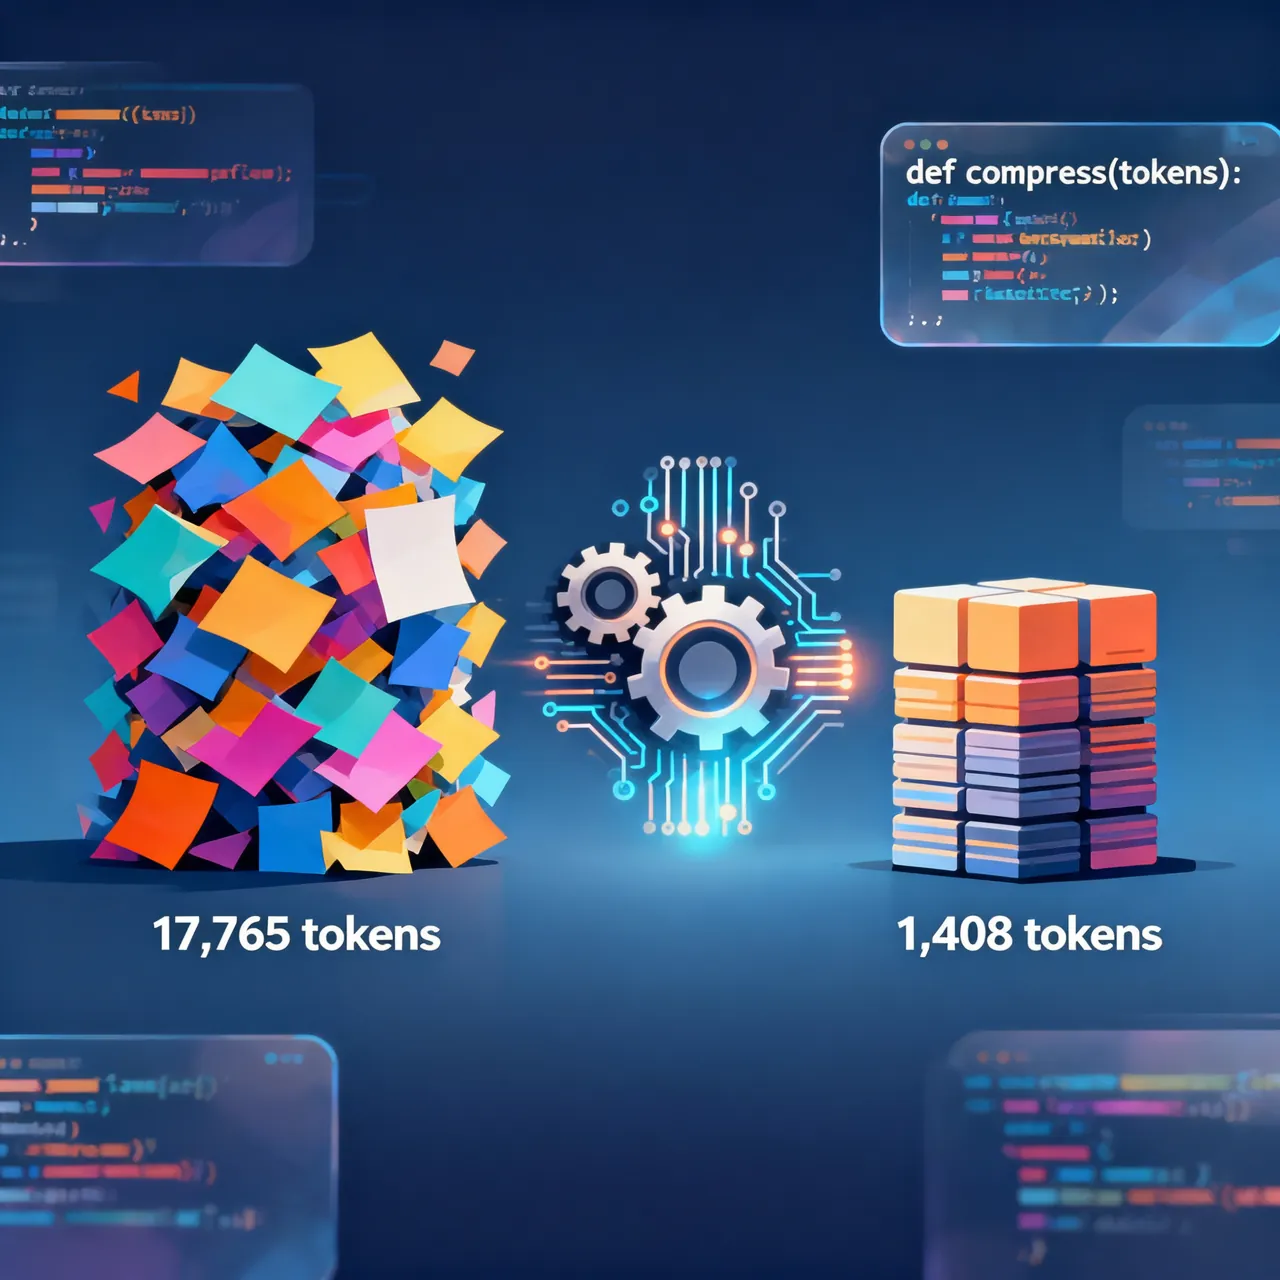
Was ist Headroom?
Headroom ist ein Open-Source-LLM-Token-Komprimierungslayer, der speziell dafür entwickelt wurde, alle Inhalte zu komprimieren, die ein KI-Agent liest – Tool-Ausgaben, Logs, RAG-Suchergebnisse, Dateien und Dialogverläufe – bevor sie an das LLM gesendet werden.
Der Kernvorteil: Die gleiche Antwort mit nur 5-40 % der Tokens. Für Entwickler, die täglich KI-Programmierassistenten (Claude Code, Cursor, Codex usw.) nutzen, bedeutet das direkte Senkung der API-Kosten um 60-95 %.
Warum braucht man Headroom?
Der typische Workflow moderner KI-Programmierassistenten sieht so aus:
Benutzerfrage → Agent durchsucht Codebase → Gibt 100+ Code-Schnipsel zurück →
Agent sammelt gesamten Kontext → Sendet an LLM → LLM antwortet
Das Problem: Der vom Agent gesendete Kontext ist größtenteils redundant. Zum Beispiel:
- Suchergebnisse liefern 100 Code-Schnipsel, aber nur 5-10 sind wirklich relevant
- Log-Dateien enthalten viele irrelevante Zeitstempel und Debug-Infos
- Von RAG abgerufene Dokumentblöcke haben viele wiederholte Präfixe
Headroom löst dieses Problem mit einer dreischichtigen Architektur:
- ContentRouter – Erkennt Inhaltstypen (JSON, Code, reiner Text) und wählt automatisch den besten Kompressor
- Intelligente Kompressoren – SmartCrusher (JSON), CodeCompressor (AST-bewusst), Kompress-base (HF-Modell)
- CCR (reversible Komprimierung) – Originaldaten werden lokal gespeichert und können bei Bedarf vom LLM abgerufen werden
Headroom im Vergleich zu anderen Lösungen
| Feature | Headroom | Native Provider-Komprimierung | Manuelles Prompt-Trimmen |
|---|---|---|---|
| Token-Einsparung | 60-95% | 20-40% | Hängt vom Menschen ab |
| Übergreifende Agent-Speicherfreigabe | ✅ | ❌ | ❌ |
| Reversible Komprimierung (CCR) | ✅ | ❌ | N/A |
| Zero-Code-Zugriff (Proxy) | ✅ | ❌ | N/A |
| Lokal ausgeführt | ✅ | ❌ (Cloud) | ✅ |
| Mehrsprachige Unterstützung | Python + TS | Nur SDK | N/A |
Headroom installieren
Headroom unterstützt Python und Node.js. Die vollständige Version wird per pip empfohlen.
Python-Installation
# Vollversion installieren (inklusive Proxy, MCP, ML und allen Funktionen)
pip install "headroom-ai[all]"

# Oder nach Bedarf Submodule installieren
pip install "headroom-ai[proxy]"   # Nur Proxy-Modus
pip install "headroom-ai[mcp]"     # Nur MCP-Server
pip install "headroom-ai[ml]"      # Machine-Learning-Kompressionsmodelle
Voraussetzung: Python 3.10+
Node.js / TypeScript-Installation
npm install headroom-ai
Installation überprüfen
# Version und Funktionen prüfen
headroom --version

# Performance-Test ausführen, um Komprimierungseffekte in der aktuellen Umgebung zu sehen
headroom perf
Schnellstart: Drei Nutzungsmodi
Headroom bietet drei Integrationsmethoden, von einfach bis komplex:
Modus Eins: Wrap-Befehl (am einfachsten, keine Konfiguration)
Wenn du bereits einen KI-Programmierassistenten verwendest, kannst du Headroom mit nur einem Befehl aktivieren:
# Claude Code wrappen
headroom wrap claude

# Codex wrappen
headroom wrap codex

# Cursor wrappen
headroom wrap cursor

# Aider wrappen
headroom wrap aider

# GitHub Copilot CLI wrappen
headroom wrap copilot
Nach der Ausführung startet Headroom automatisch: 1. Einen lokalen Proxy-Service (Standardport 8787) 2. Passt die Konfiguration des entsprechenden Agents an, um Anfragen an den Proxy weiterzuleiten 3. Druckt Konfigurationshinweise, damit du überprüfen kannst, ob alles funktioniert
Beispiel: Claude Code wrappen
$ headroom wrap claude

✅ Headroom-Proxy gestartet auf Port 8787
✅ Claude Code-Konfiguration aktualisiert

Zur Überprüfung führe aus:
  claude "Was ist 2+2?"

Du solltest Komprimierungsstatistiken in der Ausgabe sehen.
Ab jetzt wird jede Nutzung des claude-Befehls zuerst durch Headroom komprimiert, bevor sie an die Anthropic-API gesendet wird.
Modus Zwei: Proxy-Modus (keine Code-Änderungen, geeignet für jede Sprache)
Wenn du deinen bestehenden Code nicht ändern möchtest oder Tools verwendest, die Wrap nicht unterstützen, kannst du den Proxy-Service separat starten:
# Proxy starten, lauscht auf Port 8787
headroom proxy --port 8787
Ändere dann die Konfiguration deiner Anwendung oder deines Agents, sodass der API-Endpunkt auf http://localhost:8787 statt auf den ursprünglichen Anthropic/OpenAI-Endpunkt zeigt.
Beispiel: OpenAI-kompatibler Client
from openai import OpenAI

# Ursprüngliche Konfiguration
# client = OpenAI(api_key="sk-...")

# Über Headroom-Proxy leiten
client = OpenAI(
    api_key="sk-...",
    base_url="http://localhost:8787/v1"  # Zeigt auf Headroom-Proxy
)

response = client.chat.completions.create(
    model="gpt-4",
    messages=[{"role": "user", "content": "Erkläre diesen Code"}]
)
Alle über den Proxy laufenden Anfragen werden automatisch komprimiert, ohne die Geschäftslogik zu ändern.
Modus Drei: Library-Modus (am flexibelsten, in Anwendungen eingebettet)
Wenn du deine eigene KI-Anwendung entwickelst, kannst du Headrooms Kompressionsfunktionen direkt aufrufen:
Python-Beispiel
from headroom import compress

messages = [
    {"role": "user", "content": "Analysiere diese Log-Datei"},
    {"role": "assistant", "content": "Bitte stelle den Log-Inhalt bereit"},
    {"role": "user", "content": "[... 10000 Zeilen Log ...]"}
]

# Nachrichten komprimieren
compressed = compress(messages, model="claude-3-sonnet")

print(f"Originale Tokens: {compressed.original_tokens}")
print(f"Komprimierte Tokens: {compressed.compressed_tokens}")
print(f"Einsparung: {compression.savings_percent}%")

# An LLM senden
response = anthropic_client.messages.create(
    model="claude-3-sonnet-20240229",
    max_tokens=1024,
    messages=compressed.messages  # Verwende komprimierte Nachrichten
)
TypeScript-Beispiel
import { compress } from 'headroom-ai';

const messages = [
  { role: 'user', content: 'Analysiere diese Codebase' },
  { role: 'assistant', content: 'Bitte stelle die Dateien bereit' },
  { role: 'user', content: '[... 50 Dateien ...]' }
];

const compressed = await compress(messages, { model: 'gpt-4' });

console.log(`Gesparte Tokens: ${compressed.savingsPercent}%`);
Kernfunktionen im Detail
1. Intelligente Kompressionsalgorithmen
Headroom verfügt über mehrere Kompressionsalgorithmen, die je nach Inhaltstyp automatisch ausgewählt werden:
SmartCrusher – JSON-Komprimierung
Spezialisiert auf strukturierte Daten (API-Antworten, Konfigurationsdateien, Datenbankabfrageergebnisse):
from headroom import SmartCrusher

data = {
    "users": [
        {"id": 1, "name": "Alice", "email": "alice@example.com", "created_at": "2024-01-01"},
        {"id": 2, "name": "Bob", "email": "bob@example.com", "created_at": "2024-01-02"},
        # ... 1000+ Datensätze
    ]
}

crusher = SmartCrusher()
compressed = crusher.compress(data)

# Behält Schlüsselfelder bei, entfernt redundante Metadaten
# Original: 50.000 Tokens → Komprimiert: 5.000 Tokens (90% Einsparung)
CodeCompressor – AST-bewusste Code-Komprimierung
Versteht den Syntaxbaum des Codes und behält nur die Schlüsselstrukturen bei:
from headroom import CodeCompressor

code = """
def calculate_total(items):
    '''Berechnet Gesamtpreis mit Steuer'''
    total = 0
    for item in items:
        if item.active:
            total += item.price * item.quantity
    tax = total * 0.08
    return total + tax
"""

compressor = CodeCompressor(language="python")
compressed = compressor.compress(code)

# Behält Funktionssignaturen, Kontrollfluss, Schlüsselvariablen bei
# Entfernt Kommentare, Leerzeichen, nicht-kritische Implementierungsdetails
Unterstützte Sprachen: Python, JavaScript, Go, Rust, Java, C++
Kompress-base – Allgemeine Textkomprimierung
Basierend auf einem speziell trainierten HuggingFace-Modell zur Verarbeitung von natürlicher Sprache, Dokumenten, Logs usw.:
# Beim ersten Gebrauch wird das Modell automatisch heruntergeladen (ca. 500MB)
headroom proxy

# Modell-Cache-Speicherort: ~/.cache/headroom/kompress-base
2. CCR Reversible Komprimierung
CCR (Compress-Cache-Retrieve) ist Headrooms Kerninnovation: Komprimierte Daten werden an das LLM gesendet, aber die Originaldaten bleiben lokal gespeichert. Wenn das LLM vollständige Inhalte benötigt, kann es das headroom_retrieve-Tool aufrufen, um sie abzurufen.
Workflow:
1. Headroom komprimiert Inhalte → Sendet an LLM
2. LLM entdeckt Bedarf an mehr Details → Ruft headroom_retrieve(chunk_id) auf
3. Headroom gibt Originaldaten aus lokalem Cache zurück
4. LLM erhält vollständige Informationen und setzt推理 fort
Vorteile: - LLM empfängt zunächst die komprimierte Version, weniger Token-Verbrauch - Vollständige Inhalte werden nur bei Bedarf abgerufen, vermeidet einmaliges Senden großer Datenmengen - Originaldaten gehen niemals verloren
3. Übergreifende Agent-Speicherfreigabe
Wenn du mehrere KI-Assistenten gleichzeitig verwendest (z.B. Claude Code + Codex + Cursor), kann Headroom ihnen ermöglichen, komprimierten Kontext zu teilen:
# Shared Memory aktivieren
headroom wrap claude --memory
headroom wrap codex --memory
Jetzt wird der von Claude Code verarbeitete Codebase-Index zwischengespeichert, und Codex kann ihn direkt wiederverwenden, ohne erneut scannen zu müssen. Dies ist besonders nützlich für große Projekte.
4. MCP-Server-Integration
Headroom kann als MCP-Server (Model Context Protocol) laufen, und jeder MCP-kompatible Client kann ihn aufrufen:
# MCP-Server installieren
headroom mcp install

# Verfügbare MCP-Tools:
# - headroom_compress: Beliebige Inhalte komprimieren
# - headroom_retrieve: Originaldaten abrufen
# - headroom_stats: Kompressionsstatistiken anzeigen
Beispiel: Verwendung in Claude Desktop
// claude_desktop_config.json
{
  "mcpServers": {
    "headroom": {
      "command": "headroom",
      "args": ["mcp", "serve"]
    }
  }
}
Praxisbeispiele
Fall 1: Optimierung der Codebase-Suche
Szenario: KI-Assistent soll in einem Projekt mit 100.000 Codezeilen die Implementierung einer bestimmten Funktion finden.
Ohne Headroom:
Agent sucht → Gibt 100 relevante Dateien zurück → Alle an LLM senden →
Token-Verbrauch: 17.765 → Hohe Kosten, langsame Antwort
Mit Headroom:
headroom wrap claude
claude "Finde die Implementierung des Benutzer-Authentifizierungsmoduls"
Agent sucht → Headroom komprimiert 100 Dateien →
Token-Verbrauch: 1.408 → 92% Einsparung
Reale Testdaten:
| Workload | Vor Komprimierung | Nach Komprimierung | Einsparung |
|---|---|---|---|
| Code-Suche (100 Ergebnisse) | 17.765 | 1.408 | 92% |
| SRE-Incident-Debugging | 65.694 | 5.118 | 92% |
| GitHub-Issue-Klassifizierung | 54.174 | 14.761 | 73% |
| Codebase-Exploration | 78.502 | 41.254 | 47% |
Fall 2: Multi-Agent-Kollaboration
Szenario: Claude Code für Code-Review, Codex für Unit-Tests, Cursor für Refactoring.
Traditionelle Methode: Jeder Agent muss die Codebase unabhängig scannen, was Tokens doppelt verbraucht.
Mit Headroom Shared Memory:
# Schritt 1: Claude Code scannt und cached
headroom wrap claude --memory
claude "Überprüfe die Codequalität im Verzeichnis src/auth/"

# Schritt 2: Codex verwendet Cache
headroom wrap codex --memory
codex "Generiere Unit-Tests für src/auth/"
# Codex verwendet direkt den von Claude gecachten Index, kein erneutes Scannen nötig

# Schritt 3: Cursor继续使用
headroom wrap cursor --memory
cursor "Refaktoriere die Fehlerbehandlung in src/auth/"
Einspareffekt: Zweite und folgende Agents können 40-60 % der initialen Scan-Tokens einsparen.
Fall 3: Log-Datei-Analyse
Szenario: Beim Debuggen von Produktionsproblemen muss KI eine 10.000-zeilige Log-Datei analysieren.
from headroom import compress
import anthropic

# Log lesen
with open("production.log") as f:
    logs = f.read()

messages = [
    {"role": "user", "content": f"Analysiere diesen Log und finde die Fehlerursache:\n{logs}"}
]

# Komprimieren
compressed = compress(messages, model="claude-3-sonnet")

print(f"Original: {compressed.original_tokens} Tokens")
print(f"Komprimiert: {compressed.compressed_tokens} Tokens")
print(f"Einsparung: {compressed.savings_percent}%")

# Senden
client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-3-sonnet-20240229",
    max_tokens=2048,
    messages=compressed.messages
)

print(response.content[0].text)
Typischer Effekt: 65.694 Tokens → 5.118 Tokens (92% Einsparung), wobei kritische Fehlerinformationen nicht verloren gehen.
Performance-Benchmark-Tests
Headroom behält die Genauigkeit in Standard-Benchmarks bei:
| Benchmark | Kategorie | Stichproben | Baseline-Genauigkeit | Headroom-Genauigkeit | Differenz |
|---|---|---|---|---|---|
| GSM8K | Mathematik | 100 | 0,870 | 0,870 | ±0,000 |
| TruthfulQA | Faktizität | 100 | 0,530 | 0,560 | +0,030 |
| SQuAD v2 | QA | 100 | — | 97% | 19% Kompressionsrate |
| BFCL | Tool-Aufruf | 100 | — | 97% | 32% Kompressionsrate |
Fazit: Headroom erzielt signifikante Token-Einsparungen bei gleichbleibender Genauigkeit.
Benchmark reproduzieren:
python -m headroom.evals suite --tier 1
Erweiterte Konfiguration
CacheAligner – Verbesserte Provider-KV-Cache-Trefferrate
CacheAligner stabilisiert das Prompt-Präfix, sodass der KV-Cache von Anthropic/OpenAI treffen kann, was die Kosten weiter senkt:
from headroom import CompressionMiddleware

# Middleware in ASGI-App hinzufügen
app.add_middleware(CompressionMiddleware)
headroom learn – Aus Fehlern lernen
Headroom kann fehlgeschlagene Sitzungen analysieren und Korrekturen automatisch in CLAUDE.md oder AGENTS.md schreiben:
# Lernmodus aktivieren
headroom wrap claude --learn

# Wenn Claude Code eine falsche Antwort gibt, wird Headroom:
# 1. Die Ursache des Fehlers analysieren
# 2. Korrekturhinweise generieren
# 3. In die CLAUDE.md des Projekts schreiben
# 4. Bei der nächsten Sitzung automatisch anwenden
Benutzerdefinierte Kompressionsstrategien
Du kannst benutzerdefiniertes Kompressionsverhalten über Pipeline-Erweiterungen hinzufügen:
from headroom import PipelineExtension

class MyCustomCompressor(PipelineExtension):
    def on_input_received(self, event):
        # Benutzerdefinierte Logik beim Empfang von Eingaben
        print(f"Empfangen {len(event.content)} Bytes")

    def on_input_compressed(self, event):
        # Nach Abschluss der Komprimierung ausführen
        print(f"Komprimiert auf {event.compressed_size} Bytes")

# Erweiterung registrieren
pipeline.register(MyCustomCompressor())
Häufig gestellte Fragen
F1: Beeinflusst Headroom die Antwortqualität?
A: Nein. Benchmarks zeigen, dass die Genauigkeit unverändert bleibt (GSM8K: 0,870 → 0,870). Die reversible CCR-Komprimierung stellt sicher, dass das LLM jederzeit vollständige Inhalte abrufen kann.
F2: Wie steht es um die Datensicherheit?
A: Headroom läuft vollständig lokal, alle Komprimierung, Caching und Speicherung erfolgen auf deinem eigenen Rechner. Originaldaten werden an keine externen Server gesendet.
F3: Welche LLM-Provider werden unterstützt?
A: Theoretisch alle Provider, da Headroom auf Prompt-Ebene arbeitet. Bestätigt unterstützte sind: - Anthropic (Claude) - OpenAI (GPT-4, GPT-3.5) - AWS Bedrock - Google Gemini - Jede OpenAI-kompatible API
F4: Erhöht die Komprimierung die Latenz?
A: Lokale Komprimierung dauert normalerweise 10-50 ms, was im Vergleich zu Netzwerkanfragen (hunderte ms bis mehrere Sekunden) vernachlässigbar ist. Da weniger Tokens gesendet werden, ist die Gesamtantwortzeit oft schneller.
F5: Ist es für einzelne Entwickler oder Teams geeignet?
A: Für beide. - Einzelne Entwickler: Tägliche Nutzung von KI-Assistenten, spart API-Kosten - Teams: Übergreifende Agent-Speicherfreigabe, vermeidet wiederholtes Scannen der Codebase; einheitliche Kompressionsstrategie, erleichtert Kostenkontrolle
Zusammenfassung
Headroom ist ein hochwertiges Open-Source-Tool, das reale Probleme löst. Für Entwickler, die KI-Programmierassistenten intensiv nutzen, kann es:
✅ API-Kosten um 60-95% senken – Spart direkt Geld
✅ Zero-Code-Zugriff – Ein Befehl headroom wrap claude erledigt alles
✅ Übergreifende Agent-Speicherfreigabe – Claude, Codex, Cursor teilen Cache
✅ Reversible Komprimierung (CCR) – Originaldaten gehen nicht verloren, LLM kann bei Bedarf abrufen
✅ Lokal ausgeführt – Datensicher, kein Privacy-Risiko
Wenn dein Team monatlich mehr als 100 $ für LLM-APIs ausgibt, wird Headroom dir mit hoher Wahrscheinlichkeit eine Menge Geld sparen.
Sofort starten:
pip install "headroom-ai[all]"
headroom wrap claude  # Oder jeden anderen verwendeten Agent
headroom perf         # Einspareffekt anzeigen
Projekt-Adresse: https://github.com/chopratejas/headroom
Dokumentation: https://headroom-docs.vercel.app/docs