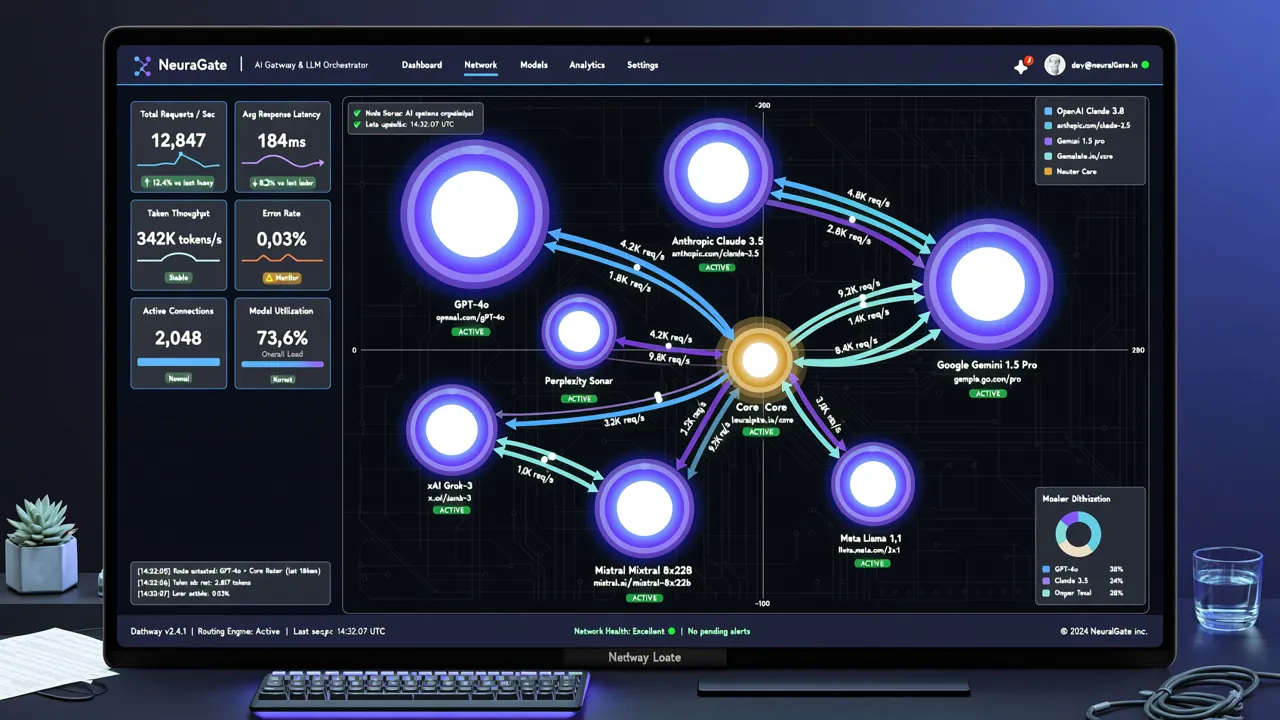
Guide complet OmniRoute : la passerelle IA gratuite pour accéder à 268+ modèles depuis un seul point
TL;DR — OmniRoute est une passerelle IA open source sous licence MIT. Elle regroupe plus de 268 fournisseurs IA (dont 50+ gratuits) derrière un seul endpoint local. Au programme : basculement automatique, compression RTK pour économiser 15 à 95 % de tokens, 18 stratégies de routage, et une compatibilité directe avec Claude Code, Cursor, Codex et d'autres outils de programmation. 23k+ étoiles et 500+ contributeurs sur GitHub.
Pourquoi utiliser OmniRoute ?
Si vous jonglez entre plusieurs services IA — OpenAI, Claude, Gemini, DeepSeek, Kimi — vous connaissez sûrement ces galères :
- Chaque outil demande sa propre clé API : un
.envpour Claude Code, un paramètre pour Cursor, une config pour Codex… - Les crédits gratuits sont éparpillés partout : chaque fournisseur offre un plan gratuit, mais les gérer à la main, c'est lourd.
- Un service tombe en panne, tout votre workflow s'arrête : sans basculement automatique, il faut changer manuellement.
- Les coûts en tokens sont imprévisibles : impossible de savoir quelle requête a coûté quoi.
OmniRoute est né pour résoudre exactement ces problèmes. Il lance une passerelle en local sur votre machine. Tous vos outils IA n'ont plus qu'à se connecter à http://localhost:11411/v1, et OmniRoute se charge de router vers le meilleur modèle et fournisseur derrière le rideau.
Fonctionnalités principales
| Fonctionnalité | Détails |
|---|---|
| 268+ fournisseurs | OpenAI, Anthropic, Google, DeepSeek, Kimi, GLM, MiniMax, etc., dont 50+ gratuits en permanence |
| 500+ modèles | GPT-4o, Claude 4, Gemini 2.5, DeepSeek V4, Qwen 3 et tous les modèles majeurs |
| 18 stratégies de routage | Priorité, pondération, optimisation des coûts, relais contextuel, fusion avec arbitrage, etc. |
| Compression RTK + Caveman | Compression cumulative de tokens, économie de 15 à 95 % sur les coûts |
| Basculement automatique (Auto-fallback) | Passage automatique au modèle suivant en cas d'épuisement de quota ou de panne |
| 104 outils MCP | Serveur MCP intégré, compatible avec 3 modes de transport |
| Protocole A2A | Communication Agent-to-Agent, support de 6 compétences |
| Multi-plateforme | Web, Desktop (Electron), Termux, PWA |
| 43 langues | Internationalisation complète |
Installation
Méthode 1 : Docker (recommandé)
# Récupérer l'image
docker pull ghcr.io/diegosouzapw/omniroute:latest

# Lancer (port 11411 par défaut)
docker run -d \
  --name omniroute \
  -p 11411:11411 \
  -v omniroute-data:/app/data \
  ghcr.io/diegosouzapw/omniroute:latest
Méthode 2 : Exécution directe avec Node.js
# Node.js 20+ requis
git clone https://github.com/diegosouzapw/OmniRoute.git
cd OmniRoute
npm install
npm start
Méthode 3 : Client bureau
Téléchargez le programme d'installation pour votre plateforme depuis les GitHub Releases :
- Windows : OmniRoute-Setup.exe
- macOS : OmniRoute-x.x.x.dmg
- Linux : OmniRoute-x.x.x.AppImage
Après le lancement, rendez-vous sur http://localhost:11411/dashboard pour accéder au panneau d'administration.
Prise en main rapide : configurez votre premier provider en 5 minutes
Étape 1 : Ajouter une clé API
Ouvrez le Dashboard → page Providers, puis cliquez sur Add Provider :
Provider: OpenAI
API Key:  sk-xxxxx(votre clé OpenAI)
Répétez l'opération pour ajouter d'autres fournisseurs. Voici les providers gratuits supportés par OmniRoute :
| Fournisseur | Crédit gratuit | Modèles |
|---|---|---|
| Google Gemini | 60 req/min | gemini-2.5-pro, gemini-2.5-flash |
| DeepSeek | Crédit offert à l'inscription | deepseek-chat, deepseek-coder |
| Groq | 30 req/min | llama-3.3-70b, gemma-2 |
| Mistral | Crédit offert à l'inscription | mistral-large, codestral |
| Kimi (Moonshot) | Crédit offert à l'inscription | moonshot-v1-auto |
Étape 2 : Tester la connexion
Envoyez un message de test depuis la page Playground du Dashboard :
# Ou testez avec curl
curl http://localhost:11411/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "auto",
    "messages": [{"role": "user", "content": "Hello!"}]
  }'
Si vous recevez une réponse normale, la configuration est réussie.
Étape 3 : Connecter vos outils de programmation
Prenons Claude Code comme exemple. Il suffit de définir les variables d'environnement :
export ANTHROPIC_BASE_URL=http://localhost:11411/v1
export ANTHROPIC_API_KEY=any  # OmniRoute en local ne nécessite pas de vraie clé
Pour Cursor : Settings → Models → Base URL → http://localhost:11411/v1, et mettez n'importe quelle valeur dans API Key.
Fonctionnalités avancées
Les 18 stratégies de routage en détail
Le vrai point fort d'OmniRoute, c'est sa richesse en stratégies de routage. Chaque scénario peut trouver sa solution optimale :
Modes de combinaison automatique (recommandé pour débuter)
Définissez le modèle sur la famille auto, et OmniRoute choisira automatiquement le meilleur provider en fonction de 12 critères (santé, quota, coût, latence, taux de succès…) :
| Model ID | Objectif d'optimisation |
|---|---|
auto |
🎯 Équilibré par défaut (LKGP — verrouillage sur le dernier provider réussi) |
auto/coding |
🧑💻 Qualité de génération de code prioritaire |
auto/fast |
⚡ Latence minimale prioritaire |
auto/cheap |
💰 Coût par token le plus bas prioritaire |
auto/offline |
🔋 Quota restant le plus élevé prioritaire |
auto/smart |
🔭 Qualité prioritaire + 10 % d'exploration de nouveaux modèles |
Exemple d'utilisation :
curl http://localhost:11411/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "auto/coding",
    "messages": [
      {"role": "system", "content": "Tu es un assistant de programmation Python"},
      {"role": "user", "content": "Écris un tri rapide en Python"}
    ]
  }'
Stratégies de routage avancées
En plus des modes automatiques, OmniRoute propose des stratégies manuelles plus poussées :
# Exemple de configuration OmniRoute
combos:
  - name: "Production"
    strategy: "cost-optimized"  # Optimisation des coûts
    targets:
      - provider: "openai"
        model: "gpt-4o-mini"
      - provider: "deepseek"
        model: "deepseek-chat"
      - provider: "groq"
        model: "llama-3.3-70b"

  - name: "Création haute qualité"
    strategy: "fusion"  # Fusion multi-modèles avec arbitrage
    targets:
      - provider: "anthropic"
        model: "claude-4-sonnet"
      - provider: "google"
        model: "gemini-2.5-pro"
      - provider: "openai"
        model: "gpt-4o"
Description des stratégies :
- priority — Vide les targets dans l'ordre, passe au suivant quand le quota est épuisé
- fill-first — Remplit chaque target de manière équitable avant de basculer
- weighted — Répartition aléatoire selon les poids assignés
- cost-optimized — Choisit le moins cher selon le catalogue de prix en temps réel
- context-relay — Transmet le contexte entre les targets, idéal pour les conversations longues
- fusion — Envoie la requête à plusieurs modèles en parallèle, puis un modèle arbitre synthétise la meilleure réponse
- pipeline — Traitement en chaîne, la sortie de chaque target devient l'entrée de la suivante
Compression de tokens : RTK + Caveman
OmniRoute intègre un double moteur de compression de tokens pour réduire significativement les coûts API :
- RTK (Relevant Token Keeper) — Filtre les tokens redondants, conserve le contexte essentiel
- Caveman — Compression structurée avec optimisations dédiées pour le chinois (mode wenyanwen), le allemand, le français et le japonais
L'utilisation combinée des deux moteurs permet d'économiser 15 à 95 % de tokens en conditions réelles :
# Activer la compression dans une requête
curl http://localhost:11411/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "auto",
    "compression": {
      "engines": ["rtk", "caveman"],
      "mode": "aggressive"  # balanced | aggressive | conservative
    },
    "messages": [...]
  }'
Comparaison des modes de compression :
| Mode | Taux de compression | Impact sur la qualité | Cas d'utilisation |
|---|---|---|---|
| conservative | 15-30 % | Presque aucun | Génération de code précise |
| balanced | 30-60 % | Impact léger | Conversations quotidiennes |
| aggressive | 60-95 % | Impact notable | Brainstorming rapide |
Partage de quota (Quota-Share)
Si vous possédez plusieurs clés API pour le même fournisseur (par exemple deux comptes OpenAI), Quota-Share permet de répartir le quota équitablement entre elles :
quota_share:
  provider: "openai"
  policy: "soft"  # hard | soft | burst
  keys:
    - key: "sk-xxx1"
      weight: 50
    - key: "sk-xxx2"
      weight: 30
    - key: "sk-xxx3"
      weight: 20
- hard — Limite stricte, la requête est refusée si le quota est dépassé
- soft — Après dépassement, la clé passe en priorité basse sans refus
- burst — Peut utiliser les parts inutilisées des autres clés
Cas pratiques : Claude Code + OmniRoute
Scénario 1 : Workflow de programmation gratuit (zéro coût)
Montez un environnement de développement entièrement avec des providers gratuits :
# 1. Configurez OmniRoute avec les providers gratuits suivants
#    - Google Gemini (60 req/min)
#    - DeepSeek (crédit d'inscription)
#    - Groq (30 req/min)
#    - Mistral (crédit d'inscription)

# 2. Activez le mode auto/cheap
export ANTHROPIC_BASE_URL=http://localhost:11411/v1
export ANTHROPIC_API_KEY=any

# 3. Lancez Claude Code, le routage vers les modèles gratuits est automatique
claude 'Aide-moi à restructurer les dossiers de ce projet Python'
Scénario 2 : Environnement haute disponibilité (basculement automatique)
# Chaîne de fallback : Claude → GPT-4o → Gemini → DeepSeek
# OmniRoute bascule automatiquement en cas de problème à n'importe quel niveau

export ANTHROPIC_BASE_URL=http://localhost:11411/v1
export ANTHROPIC_API_KEY=any

# Même si le service Claude tombe, votre workflow ne s'interrompt pas
claude 'Analyse les problèmes de sécurité mémoire dans ce code Rust'
Scénario 3 : Comparaison multi-modèles (mode Fusion)
curl http://localhost:11411/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "auto",
    "strategy": "fusion",
    "messages": [
      {"role": "user", "content": "Explique le modèle de propriété de Rust avec des exemples de code"}
    ]
  }'
Le mode Fusion interroge plusieurs modèles en parallèle. Un modèle arbitre (comme GPT-4o-mini) synthétise ensuite la meilleure réponse possible. Idéal pour les scénarios où la qualité du code est critique.
Comparaison avec les autres passerelles IA
| Fonctionnalité | OmniRoute | LiteLLM | OpenRouter | Portkey |
|---|---|---|---|---|
| Nombre de providers | 268+ | ~100 | ~30 | ~20 |
| Providers gratuits | 50+ | Très peu | Peu | Peu |
| Stratégies de routage | 18 | 3 | 1 | 2 |
| Compression de tokens | RTK + Caveman | Non | Non | Non |
| Support MCP | 104 outils | Basique | Non | Limité |
| Licence | MIT | MIT | Commerciale | Commerciale |
| Client bureau | Oui | Non | Non | Non |
Résumé
OmniRoute est aujourd'hui l'une des passerelles IA open source les plus complètes. Il résout les trois problèmes majeurs de la gestion multi-fournisseurs :
- Accès unifié — Un seul endpoint pour configurer tous vos outils IA
- Routage intelligent — 18 stratégies + basculement automatique, toujours disponible
- Optimisation des coûts — Agrégation de plans gratuits + compression de tokens, des économies immédiates
Pour les développeurs qui utilisent quotidiennement des outils de programmation IA, OmniRoute mérite une place dans votre stack technique. Licence MIT, communauté active (500+ contributeurs), mises à jour fréquentes (v3.8.20 → v3.8.49) : c'est un projet à suivre de près.
Adresse du projet : github.com/diegosouzapw/OmniRoute ⭐ 23k+ étoiles
Utile ? Mettez une étoile à OmniRoute, ou partagez votre configuration dans les commentaires ! Si les passerelles IA, le routage LLM et les sujets connexes vous intéressent, n'hésitez pas à suivre dashen-tech.com.