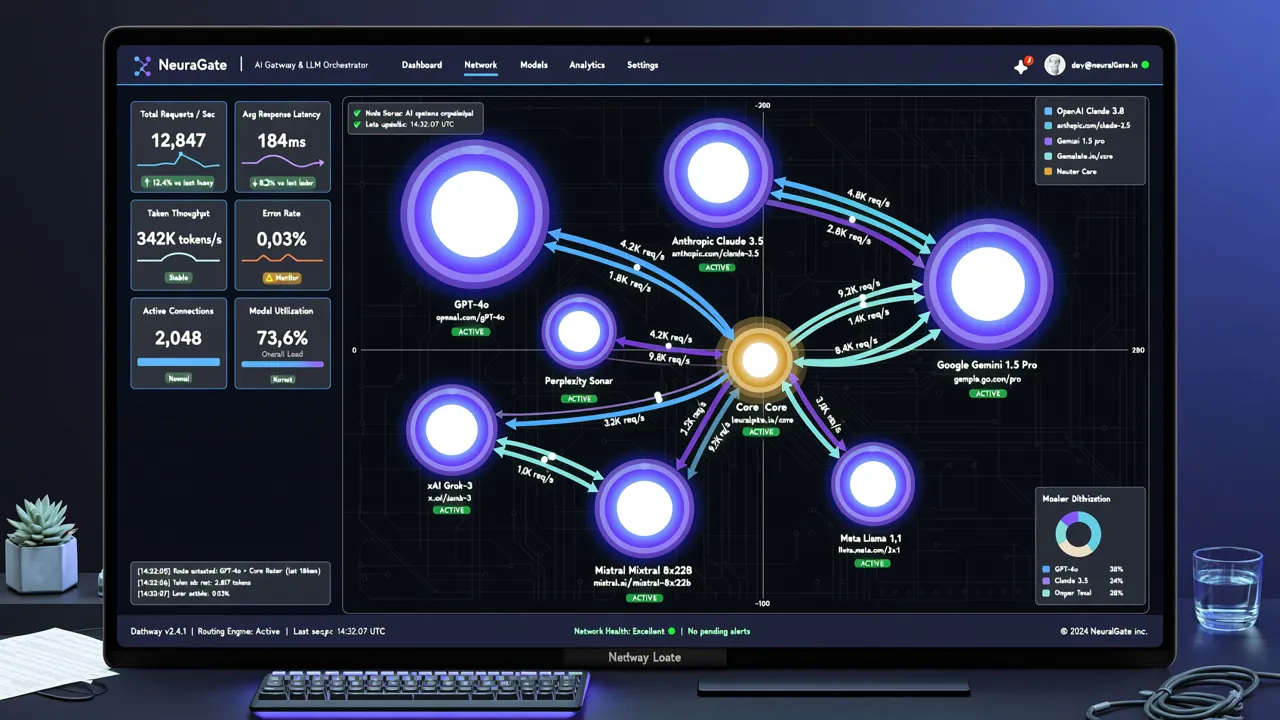
OmniRoute 完全ガイド:無料の AI ゲートウェイ、1 つのエンドポイントで 268+ の大規模モデルに接続
TL;DR — OmniRoute は MIT ライセンスのオープンソース AI ゲートウェイです。268 以上の AI プロバイダー(うち 50 以上が無料)を 1 つのローカルエンドポイントに集約します。自動フォールバック、RTK 圧縮で 15〜95% のトークン節約、18 種類のルーティング戦略に対応。Claude Code、Cursor、Codex などのプログラミングツールと直接連携できます。GitHub で 23k+ スター、500+ コントリビューター。
なぜ OmniRoute が必要なのか?
OpenAI、Claude、Gemini、DeepSeek、Kimi といった複数の AI サービスを同時に使っていると、こんな悩みがありませんか?
- ツールごとに API Key を個別に設定するのが面倒:Claude Code は
.env、Cursor は設定画面、Codex はまた別の設定 - 無料枠があちこちに散らばっている:各社とも無料 tier はあるけど、手動で管理するのは疲れる
- あるサービスがダウンするとワークフロー全体が止まる:自動フォールバックがないと手動で切り替えるしかない
- トークン費用が把握しにくい:どのリクエストにいくら使ったのかわからない
OmniRoute はこうした問題を解決するために作られました。ローカルでゲートウェイを動かすだけで、すべての AI ツールが http://localhost:11411/v1 に接続するだけで OK。OmniRoute が裏側で最適なモデルとプロバイダーにルーティングしてくれます。
主要機能
| 機能 | 説明 |
|---|---|
| 268+ プロバイダー | OpenAI、Anthropic、Google、DeepSeek、Kimi、GLM、MiniMax など、うち 50 以上が永久無料 |
| 500+ モデル | GPT-4o、Claude 4、Gemini 2.5、DeepSeek V4、Qwen 3 など主要モデルをすべてカバー |
| 18 種類のルーティング戦略 | 優先順位、重み付け、コスト最適化、コンテキストリレー、融合評価など |
| RTK + Caveman 圧縮 | 2 つのトークン圧縮を組み合わせ、15〜95% のトークン費用を節約 |
| 自動フォールバック (Auto-fallback) | クォータ枯渇やサービス障害時に次の利用可能なモデルに自動切り替え |
| 104 個の MCP ツール | MCP サーバー内蔵、3 種類の転送方式に対応 |
| A2A プロトコル | Agent-to-Agent 通信、6 種類のスキルに対応 |
| マルチプラットフォーム | Web、Desktop (Electron)、Termux、PWA |
| 43 言語対応 | 完全な国際化サポート |
インストール
方法一:Docker(推奨)
# イメージをプル
docker pull ghcr.io/diegosouzapw/omniroute:latest

# 起動(デフォルトポート 11411)
docker run -d \
  --name omniroute \
  -p 11411:11411 \
  -v omniroute-data:/app/data \
  ghcr.io/diegosouzapw/omniroute:latest
方法二:Node.js で直接実行
# Node.js 20+ が必要
git clone https://github.com/diegosouzapw/OmniRoute.git
cd OmniRoute
npm install
npm start
方法三:デスクトップクライアント
GitHub Releases から各プラットフォーム用のインストーラーをダウンロード:
- Windows: OmniRoute-Setup.exe
- macOS: OmniRoute-x.x.x.dmg
- Linux: OmniRoute-x.x.x.AppImage
起動後、http://localhost:11411/dashboard にアクセスすると管理画面が開きます。
クイックスタート:5 分で最初の Provider を設定
ステップ 1: API Key を追加
Dashboard → Providers ページを開き、Add Provider をクリック:
Provider: OpenAI
API Key:  sk-xxxxx(あなたの OpenAI Key)
この手順を繰り返して、さらに多くのプロバイダーを追加します。OmniRoute がサポートする無料プロバイダーの一部をご紹介します:
| プロバイダー | 無料枠 | モデル |
|---|---|---|
| Google Gemini | 60 req/分 | gemini-2.5-pro, gemini-2.5-flash |
| DeepSeek | 登録時に残額付与 | deepseek-chat, deepseek-coder |
| Groq | 30 req/分 | llama-3.3-70b, gemma-2 |
| Mistral | 登録時に残額付与 | mistral-large, codestral |
| Kimi (Moonshot) | 登録時に残額付与 | moonshot-v1-auto |
ステップ 2: 接続をテスト
Dashboard の Playground ページでテストメッセージを送信します:
# または curl でテスト
curl http://localhost:11411/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "auto",
    "messages": [{"role": "user", "content": "Hello!"}]
  }'
正常なレスポンスが返ってくれば、設定完了です。
ステップ 3: プログラミングツールを接続
Claude Code の例では、環境変数を設定するだけ:
export ANTHROPIC_BASE_URL=http://localhost:11411/v1
export ANTHROPIC_API_KEY=any  # ローカルでは実際は本物のキーは不要
Cursor ユーザーの場合:Settings → Models → Base URL に http://localhost:11411/v1 を入力、API Key は任意の値を設定します。
上級機能
18 種類のルーティング戦略 詳細解説
OmniRoute の真価は、豊富なルーティング戦略にあります。シーンごとに最適な戦略を選べます:
自動組み合わせモード(入門に推奨)
model を auto シリーズに設定すると、OmniRoute が 12 の要素(ヘルス、クォータ、コスト、レイテンシ、成功率…)に基づいて自動スコアリングで選択します:
| モデル ID | 最適化目標 |
|---|---|
auto |
🎯 バランス標準(LKGP — 最後に成功したプロバイダーを保持) |
auto/coding |
🧑💻 コード生成の品質優先 |
auto/fast |
⚡ 最低レイテンシ優先 |
auto/cheap |
💰 トークン単価最安優先 |
auto/offline |
🔋 残りのクォータ最多優先 |
auto/smart |
🔭 品質優先 + 10% で新モデルを探索 |
使用例:
curl http://localhost:11411/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "auto/coding",
    "messages": [
      {"role": "system", "content": "あなたは Python プログラミングのアシスタントです"},
      {"role": "user", "content": "Python でクイックソートを書いてください"}
    ]
  }'
高度なルーティング戦略
自動モードのほか、手動で組み立てられる高度な戦略もサポートしています:
# OmniRoute の設定例
combos:
  - name: "本番環境"
    strategy: "cost-optimized"  # コスト最適化
    targets:
      - provider: "openai"
        model: "gpt-4o-mini"
      - provider: "deepseek"
        model: "deepseek-chat"
      - provider: "groq"
        model: "llama-3.3-70b"

  - name: "高品質クリエイティブ"
    strategy: "fusion"  # 複数モデルの融合 + 評価
    targets:
      - provider: "anthropic"
        model: "claude-4-sonnet"
      - provider: "google"
        model: "gemini-2.5-pro"
      - provider: "openai"
        model: "gpt-4o"
戦略の説明:
- priority — 順番に使い切り、1 つ使い切ったら次に切り替え
- fill-first — 各ターゲットのクォータをすべて埋めてから切り替え
- weighted — 重みに基づいてランダム割り当て
- cost-optimized — リアルタイム価格カタログから最安を選択
- context-relay — ターゲット間でコンテキストを受け渡し、長時間の会話に最適
- fusion — 同時に複数モデルにリクエストを送り、評価モデルが最適解を合成
- pipeline — チェーン処理。各ターゲットの出力が次の入力になる
トークン圧縮:RTK + Caveman
OmniRoute には 2 つのトークン圧縮エンジンが内蔵されており、API 費用を大幅に削減できます:
- RTK(Relevant Token Keeper) — 冗長なトークンをフィルタリングし、重要なコンテキストを保持
- Caveman — 構造化圧縮。中国語(文言文モード)、ドイツ語、フランス語、日本語にそれぞれ専用最適化
2 つを組み合わせることで、実際のシーンで 15〜95% のトークン費用を節約できます:
# リクエストで圧縮を有効化
curl http://localhost:11411/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "auto",
    "compression": {
      "engines": ["rtk", "caveman"],
      "mode": "aggressive"  # balanced | aggressive | conservative
    },
    "messages": [...]
  }'
圧縮モードの比較:
| モード | 圧縮率 | 品質への影響 | 適用シーン |
|---|---|---|---|
| conservative | 15〜30% | ほとんど影響なし | 正確なコード生成 |
| balanced | 30〜60% | 軽微な影響 | 日常の対話 |
| aggressive | 60〜95% | 明らかな影響 | 素早いブレインストーミング |
クォータ共有 (Quota-Share)
同じプロバイダーの API Key が複数ある場合(たとえば 2 つの OpenAI アカウント)、Quota-Share でクォータを公平に配分できます:
quota_share:
  provider: "openai"
  policy: "soft"  # hard | soft | burst
  keys:
    - key: "sk-xxx1"
      weight: 50
    - key: "sk-xxx2"
      weight: 30
    - key: "sk-xxx3"
      weight: 20
- hard — 厳格に制限。クォータ超過でリクエストを拒否
- soft — 超過後は優先度を下げるが拒否しない
- burst — 空き枠を使い回せる
実践ケース:Claude Code + OmniRoute
シーン 1:無料プログラミングワークフロー(ゼロコスト)
無料プロバイダーだけでプログラミング環境を構築:
# 1. OmniRoute に以下の無料プロバイダーを設定
#    - Google Gemini(60 req/分)
#    - DeepSeek(登録時に付与)
#    - Groq(30 req/分)
#    - Mistral(登録時に付与)

# 2. auto/cheap モードに設定
export ANTHROPIC_BASE_URL=http://localhost:11411/v1
export ANTHROPIC_API_KEY=any

# 3. Claude Code を実行。自動的に無料モデルにルーティングされる
claude 'この Python プロジェクトのディレクトリ構造をリファクタリングして'
シーン 2:高可用性プログラミング環境(自動フォールバック)
# フォールバックチェーンを設定:Claude → GPT-4o → Gemini → DeepSeek
# OmniRoute はどの段階でも自動的にフォールバックする

export ANTHROPIC_BASE_URL=http://localhost:11411/v1
export ANTHROPIC_API_KEY=any

# Claude がダウンしていても、ワークフローは中断しない
claude 'この Rust コードのメモリセキュリティの問題を分析して'
シーン 3:マルチモデル比較(Fusion モード)
curl http://localhost:11411/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "auto",
    "strategy": "fusion",
    "messages": [
      {"role": "user", "content": "Rust の所有権モデルを説明し、コード例で示してください"}
    ]
  }'
Fusion モードは複数のモデルに同時にリクエストを送り、評価モデル(GPT-4o-mini など)が最適解を合成します。コード品質が極めて重要な場面に適しています。
他の AI ゲートウェイとの比較
| 機能 | OmniRoute | LiteLLM | OpenRouter | Portkey |
|---|---|---|---|---|
| プロバイダー数 | 268+ | 約 100 | 約 30 | 約 20 |
| 無料プロバイダー | 50+ | 極めて少ない | 少ない | 少ない |
| ルーティング戦略 | 18 種類 | 3 種類 | 1 種類 | 2 種類 |
| トークン圧縮 | RTK + Caveman | なし | なし | なし |
| MCP サポート | 104 ツール | 基本機能 | なし | 制限あり |
| オープンソースライセンス | MIT | MIT | 商用 | 商用 |
| デスクトップクライアント | あり | なし | なし | なし |
まとめ
OmniRoute は現在最も機能が充実したオープンソース AI ゲートウェイのひとつです。マルチプロバイダー管理の 3 つの課題を解決します:
- 一元化された接続 — 1 つのエンドポイントですべての AI ツールの設定を完了
- インテリジェントルーティング — 18 種類の戦略 + 自動フォールバックで、いつでもオンライン
- コスト最適化 — 無料 tier の集約 + トークン圧縮で、すぐに効果を実感できる節約
日常 AI プログラミングツールを使う開発者にとって、OmniRoute は技術スタックに加える価値のあるプロジェクトです。MIT ライセンス、活発なコミュニティ(500+ コントリビューター)、頻繁なアップデート(v3.8.20 → v3.8.49)。継続的にチェックする価値があります。
プロジェクト URL: github.com/diegosouzapw/OmniRoute ⭐ 23k+ スター
役に立ったと思ったら? OmniRoute に Star をつけてもらうか、コメント欄で設定構成をシェアしてください!AI ゲートウェイや LLM ルーティングに関心がある方は、dashen-tech.com をぜひ引き続きご覧ください。