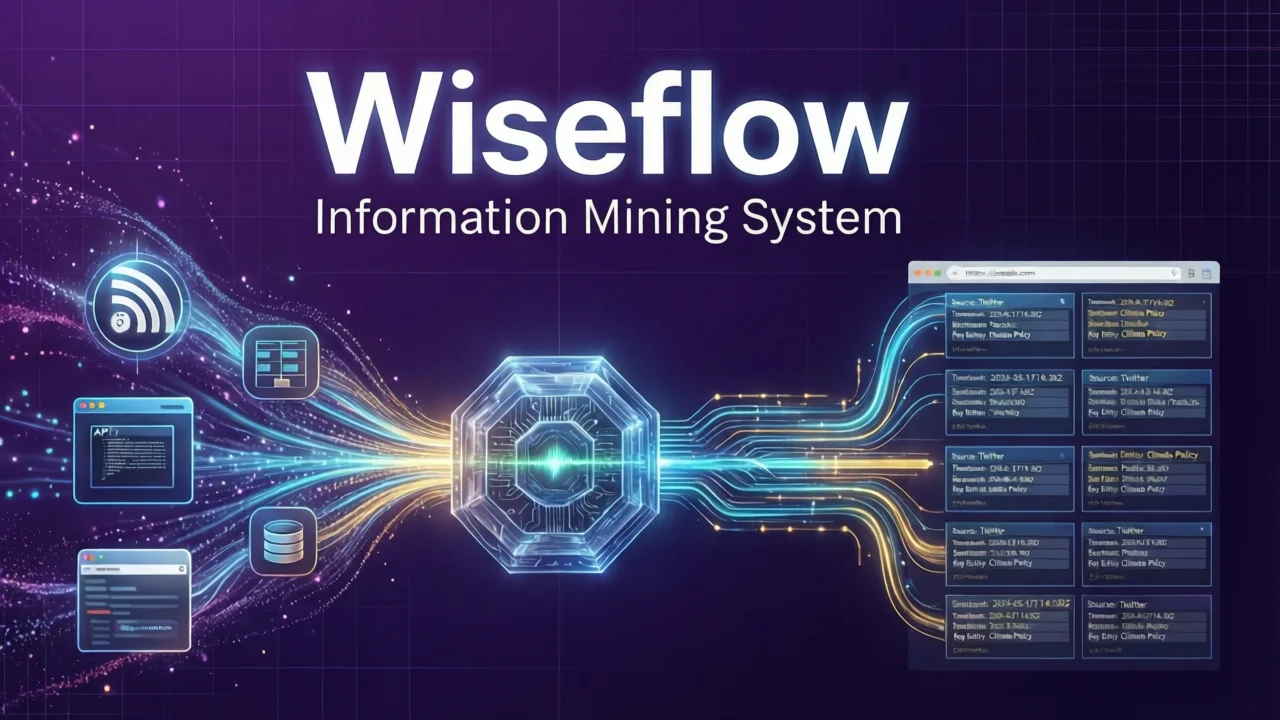
情報過多時代の突破口
毎日2.5 quintillion バイトのデータが生成されているが、本当に価値のある情報は1%未満かもしれない。開発者、起業家、マーケティング担当者が直面する核心的な問題は、「情報が見つからない」ことではなく、「膨大なノイズから actionable intelligence を抽出できない」ことである。
Wiseflow プロジェクトは当初「AI 首席情報官」として登場した——ウェブサイト、WeChat 公式アカウント、ソーシャルプラットフォームなどの情報源から、設定された関心ポイントに従って情報を抽出し、自動的にタグ付けしてデータベースにアップロードできる、俊敏なオープンソース情報マイニングツールである。現在、このプロジェクトは小贝(xiaobei)へと進化し、OPC/中小企業向けに設計された自媒体集客インテリジェントエージェントとなった。基盤アーキテクチャは openclaw に基づいており、GitHub で8,400以上のスターを獲得している。
本記事では、Wiseflow/小贝の技術アーキテクチャ、中核機能、デプロイ実践、そしてエージェントプロジェクトに動的ナレッジベースとして統合する方法を深く解析する。
中核機能の全体像
マルチ情報源 Smart Search:18種類の情報源をゼロ設定でカバー
Wiseflow の最も重要な機能の一つは、組み込みの Smart Search システムであり、以下の18種類の情報源をカバーする:
| 情報源カテゴリー | プラットフォーム | 特徴 |
|---|---|---|
| ソーシャルメディア | 小紅書、抖音、微博、知乎、B站 | 国内主要ソーシャルプラットフォームを完全カバー |
| 国際プラットフォーム | Twitter/X、YouTube、LinkedIn、Reddit | 海外情報源をワンクリックで接続 |
| コンテンツプラットフォーム | WeChat 公式アカウント、動画アカウント | WeChat エコシステムとの深い統合 |
| 垂直分野 | ニュース、政府、財務、学術、ショッピング | 専門分野を正確にカバー |
| 開発者 | GitHub | 技術動向をリアルタイムで追跡 |
重要な優位性:API キーの設定は一切不要で、完全に無料で使用できる。これは、従来の情報監視ツールが各プラットフォームごとにAPIアクセスを申請する必要があることと対照的である。
関心ポイント駆動の抽出エンジン
単純なクローラーやRSSアグリゲーターとは異なり、Wiseflow は関心ポイント駆動の情報抽出モードを採用している:
- 関心ポイントの設定:関心のあるトピック、キーワード、エンティティを定義する
- インテリジェント抽出:LLM エンジンが生のコンテンツから関心ポイントに関連する情報を抽出する
- 自動分類:セマンティック理解に基づいて自動的にタグ付け、分類する
- 構造化保存:抽出結果をデータベースにアップロードし、後続のクエリと分析をサポートする
このモードの核心的価値は「関心のあるものだけを抽出する」ことにあり、情報ノイズを大幅に低減する。
マルチエージェント協調アーキテクチャ
小贝はマルチエージェント協調アーキテクチャを採用し、4つの専門 Crew を内蔵している:
crews/
├── main/              # メインエージェント:新媒体運営/起業パートナー
├── it-engineer/       # IT エンジニア:バックエンド運用+トラブルシューティング
├── content-producer/  # コンテンツ制作者:動画/ビジュアル制作
└── sales-cs/          # 販売カスタマーサービス:顧客対応(必要に応じて有効化)
各 Crew は独立した SOUL.md(人格定義)、IDENTITY.md(アイデンティティ設定)、MEMORY.md(記憶システム)、スキルセットを持ち、openclaw フレームワークを通じて協調を実現する。
フルチェーンコンテンツ制作
情報収集からコンテンツ公開まで、小贝は完全なワークフローをカバーする:
- 情報収集:Smart Search 18種類の情報源
- コンテンツ制作:WeChat 公式アカウント記事、小紅書グラフィックテキスト、ショート動画スクリプト
- ビジュアルデザイン:ポスター生成、グラフィックレイアウト、動画カバー
- 動画制作:ショート動画生成、口出し動画編集、ハイライトクリップ抽出
- マルチプラットフォーム配信:WeChat 動画アカウント、抖音、小紅書、B站、快手、Twitter/X など
- データレビュー:公開データの自動取得、コンテンツスコアリング、戦略最適化
技術アーキテクチャの深層解析
情報源収集レイヤー
Wiseflow の収集レイヤーは、フォークされた camoufox-cli に基づいて構築されたアンチフィンガープリントブラウザスタックである:
収集レイヤーアーキテクチャ
├── camoufox-cli (forked)    # アンチフィンガープリント Firefox ブラウザ自動化
│   ├── 永続セッション       # プラットフォームごとに1つだけのセッション
│   ├── cookie+UA 二重エクスポート # ログイン状態を完全に保持
│   └── ヘッド/ヘッドレスモード切り替え # ログインはヘッド、自動化はヘッドレス
├── login-manager            # 中央ログイン状態管理
│   └── ~/.openclaw/logins/  # プラットフォーム cookie 統一保存
└── プラットフォーム固有 skill # 各プラットフォームの収集ロジックをカプセル化
設計原則: - プラットフォームごとに1つの永続セッションを使用し、複数セッションによるリスク管理トリガーを回避 - cookie のインポートによるセッション作成を厳禁(デバイスフィンガープリントの不一致がプラットフォーム検出をトリガー) - プロファイル消失時は再作成+再ログイン、古い cookie のインポートは絶対に行わない
LLM 抽出エンジン
情報抽出の中核は LLM エンジンであり、複数のモデル接続をサポートする:
| モデル | 用途 | 接続方法 |
|---|---|---|
| DeepSeek-V4-Flash | メインモデル | 阿里雲百炼 Token Plan |
| GLM-5.2 | 代替メインモデル | 火山方舟 Coding Plan |
| Qwen3.6-Flash | 軽量タスク | 阿里雲百炼 |
| doubao-seedream-4.0 | 画像生成 | 火山方舟 |
推奨設定:阿里雲百炼 Token Plan(Lite版 39元/月、Standard版 139元/月)、1つのキーでメインモデル、ビジュアルモデル、代替モデルをカバー。
タグ分類システム
抽出された情報はセマンティック理解を通じて自動的に分類される:
- エンティティ認識:人名、会社名、製品名、技術用語を認識
- トピック分類:事前定義されたタグ体系に基づいて自動分類
- 感情分析:情報の感情傾向を判断(ポジティブ/ネガティブ/ニュートラル)
- 重要度スコアリング:LLM が関心ポイントとの関連性を評価
データベース保存
抽出結果は複数の保存方法をサポートする:
- SQLite:ローカル軽量保存、シングルサーバーデプロイに適している
- PostgreSQL:本番環境推奨、並行クエリをサポート
- ベクトルデータベース:オプションで接続可能、セマンティック検索をサポート
データ構造例:
CREATE TABLE extracted_info (
    id INTEGER PRIMARY KEY,
    source_type VARCHAR(50),      -- 情報源タイプ
    source_url TEXT,              -- 元リンク
    title TEXT,                   -- タイトル
    content TEXT,                 -- 抽出コンテンツ
    focus_points JSON,            -- マッチした関心ポイント
    tags JSON,                    -- 自動タグ
    sentiment VARCHAR(20),        -- 感情傾向
    relevance_score FLOAT,        -- 関連性スコア
    extracted_at TIMESTAMP,       -- 抽出時刻
    metadata JSON                 -- 拡張メタデータ
);
ローカルデプロイ実践
ハードウェア要件
Wiseflow/小贝のハードウェア要件は非常に低く、GPU なしで完全にローカルデプロイ可能:
| 設定 | 最低要件 | 推奨設定 |
|---|---|---|
| CPU | 2 コア | 4 コア+ |
| メモリ | 4GB | 8GB+ |
| ストレージ | 10GB | 20GB+ |
| システム | Ubuntu 22.04 / macOS / WSL2 | Ubuntu 22.04 LTS |
注意:Windows 10 1803+ は Git Bash または WSL2 のインストールが必要で、シンボリックリンクをサポートするために開発者モードを有効にすることを推奨。
ワンクリックインストール(推奨)
macOS / Linux(GitHub 回線):
bash -c "$(curl -fsSL https://raw.githubusercontent.com/TeamWiseFlow/wiseflow/master/scripts/install.sh)"
macOS / Linux(国内 atomgit 回線):
bash -c "$(curl -fsSL https://raw.atomgit.com/wiseflow/wiseflow/raw/master/scripts/install-atomgit.sh)"
Windows PowerShell(管理者権限で実行):
# GitHub 回線
irm https://raw.githubusercontent.com/TeamWiseFlow/wiseflow/master/scripts/install.ps1 | iex

# 国内 atomgit 回線
irm https://raw.atomgit.com/wiseflow/wiseflow/raw/master/scripts/install-atomgit.ps1 | iex
インストールスクリプトは自動的に以下を実行:
1. 構築済み tarball(約140MB)+ Firefox アンチフィンガープリントブラウザ(約557MB)をダウンロード
2. ~/xiaobei/(プログラムディレクトリ)に展開
3. ~/.openclaw/(実行データディレクトリ)を初期化
4. WeChat バインディング QR コードを表示(スマホ WeChat でスキャンするだけで使用可能)
API キーの設定
インストール完了後、手動で設定が必要なのは LLM API キーのみ:
# 設定ファイルを編集
nano ~/.openclaw/daemon.env

# 阿里雲百炼 Key を追加
AWK_API_KEY=your_api_key_here

# 動画生成機能が必要な場合、追加設定
MODELSTUDIO_API_KEY=your_modelstudio_key
起動と使用
# メインエージェントを起動
cd ~/xiaobei
./bin/openclaw start main

# または WeChat 経由で直接対話(インストール時にバインディング済み)
ディレクトリ構造説明
~/xiaobei/              # プログラムディレクトリ(アップグレード時に置換)
├── openclaw/           # アップストリームエンジン
├── crews/              # Crew テンプレート
├── skills/             # 共通スキル
├── scripts/            # ユーティリティスクリプト
└── bin/openclaw        # 起動ラッパー

~/.openclaw/            # 実行データ(ユーザーデータ、アップグレード時に保持)
├── openclaw.json       # 設定ファイル
├── daemon.env          # 環境変数(API キー)
├── workspaces/         # 各 Crew のワークスペース
├── logins/             # プラットフォームログイン状態
└── logs/               # 実行ログ
実践ケース
ケース1:技術ニュースの監視
シナリオ:AI エージェント、LLM、オープンソースツールなどの分野の最新動向を追跡。
設定:
{
  "focus_points": [
    "AI エージェントフレームワーク",
    "LLM 新モデルリリース",
    "オープンソースツール GitHub trending",
    "RAG 技術進歩"
  ],
  "sources": ["GitHub", "Twitter/X", "知乎", "WeChat 公式アカウント"],
  "schedule": "every 6 hours",
  "output": "daily_digest"
}
効果:毎日自動的に技術日報を生成し、無関係な内容をフィルタリングし、関心ポイントに高度に関連する情報のみを保持。
ケース2:競合動向の追跡
シナリオ:競合他社の製品アップデート、市場活動、ユーザーフィードバックを監視。
設定:
{
  "focus_points": [
    "競合A 新機能リリース",
    "競合B ユーザー評価",
    "競合C 価格変更"
  ],
  "sources": ["Twitter/X", "小紅書", "微博", "製品公式サイト"],
  "sentiment_analysis": true,
  "alert_threshold": 0.8
}
効果:競合動向をリアルタイムでキャッチし、ネガティブ評価を自動警告し、市場変化に迅速に対応。
ケース3:エージェント動的ナレッジベースの構築
シナリオ:Wiseflow をエージェントプロジェクトの情報入力モジュールとして使用し、動的ナレッジベースを構築。
統合ソリューション:
# 疑似コード例:エージェントが Wiseflow を呼び出して最新情報を取得
class AgentWithWiseflow:
    def __init__(self):
        self.wiseflow_db = connect_to_wiseflow_db()

    def get_context(self, query: str):
        # Wiseflow データベースから関連情報を取得
        results = self.wiseflow_db.query(
            focus_points=[query],
            limit=10,
            min_relevance=0.7
        )
        return self.format_as_context(results)

    def respond(self, user_input: str):
        # Wiseflow が提供する動的情報を組み合わせて回答を生成
        context = self.get_context(user_input)
        return self.llm.generate(user_input, context=context)
優位性:エージェントはもはや静的ナレッジベースに依存せず、リアルタイムで更新される外部情報にアクセスできる。
エージェントプロジェクトとの統合
ナレッジベースモジュールとして
Wiseflow が抽出した構造化データは、エージェントのナレッジベースとして直接使用できる:
- データベース直接接続:エージェントが Wiseflow の SQLite/PostgreSQL データベースを直接クエリ
- API インターフェース:Wiseflow が提供する API を通じて最新情報を取得
- ベクトル検索:抽出結果をベクトルデータベースにインポートし、セマンティック検索をサポート
RAG との組み合わせ
Wiseflow を RAG(Retrieval-Augmented Generation)の情報源として使用:
ユーザー質問 → エージェントが受信
         ↓
Wiseflow が関連ドキュメントを検索
         ↓
強化プロンプトを構築
         ↓
LLM が回答を生成(最新情報に基づく)
マルチエージェント協調
openclaw フレームワーク下で、Wiseflow の複数の Crew が協調して複雑なタスクを完了できる:
- main エージェント:ユーザーニーズを受け取り、タスクを分解
- content-producer:Wiseflow が抽出した情報に基づいてコンテンツを生成
- it-engineer:システムの安定性を維持し、技術問題を処理
他の情報監視ツールとの比較
| 機能 | Wiseflow/小贝 | Huginn | RSS+LLM | 商用ソリューション |
|---|---|---|---|---|
| 情報源カバー | 18種類(ソーシャル+ニュース+垂直) | 主に Web | RSS のみ | プロバイダーによる |
| API キー必要性 | 不要(Smart Search) | 設定必要 | 設定必要 | 有料 |
| 情報抽出 | LLM 関心ポイント駆動 | ルールエンジン | 単純要約 | ソリューションによる |
| 自動分類 | セマンティックタグ | 手動ルール | なし | 一部サポート |
| コンテンツ制作 | フルチェーン(テキスト+画像+動画) | なし | なし | 一部サポート |
| マルチプラットフォーム公開 | 10+ プラットフォーム | なし | なし | ソリューションによる |
| ローカルデプロイ | サポート、ハードウェア要件低 | サポート | サポート | サポートなし |
| オープンソース無料 | 完全オープンソース | オープンソース | オープンソース | 有料 |
| エージェント統合 | ネイティブサポート | 開発必要 | 開発必要 | サポートなし |
Wiseflow の中核優位性: 1. ゼロ設定情報源接続:Smart Search は各プラットフォームごとにAPIを申請不要 2. 関心ポイント駆動:単純クロールではなく、ニーズに応じて抽出 3. フルチェーンクローズドループ:情報収集からコンテンツ公開までワンストップで完了 4. エージェントネイティブ統合:エージェントのナレッジベースモジュールとして直接使用可能
制限事項と注意事項
現在の制限
- アンチフィンガープリントブラウザ依存:camoufox-cli は約557MBの Firefox ブラウザをダウンロードする必要があり、初回インストールは比較的遅い
- プラットフォームリスク管理:頻繁な収集はプラットフォームのリスク管理をトリガーする可能性があり、頻度を適切に制御する必要がある
- ログイン状態の維持:一部のプラットフォームは定期的に再ログインする必要があり、cookie の期限切れは手動で処理する必要がある
- Windows サポート:Git Bash または WSL2 のインストールが必要で、ネイティブサポートは弱い
ベストプラクティス
- 収集頻度の制御:高頻度でプラットフォームのリスク管理をトリガーしないよう、6時間ごとの収集を推奨
- 関心ポイントの適切な設定:関心ポイントがより正確であればあるほど、抽出効果が向上し、ノイズが減少
- ログイン状態の定期維持:各プラットフォームの cookie が期限切れになっていないか確認し、タイムリーに再ログイン
- 国内回線の使用:国内ユーザーは atomgit 回線を使用し、GitHub アクセス問題を回避することを推奨
- 実行データのバックアップ:
~/.openclaw/ディレクトリを定期的にバックアップし、データ損失を防止
コンプアンスリマインダー
- 各プラットフォームの利用規約と robots.txt ルールを遵守
- プライバシー情報や機密データの収集に使用しない
- 商業利用時は著作権問題に注意
- 高頻度収集はIPブロックにつながる可能性があり、プロキシの使用を推奨
総括評価
Wiseflow/小贝は、情報マイニングツールから万能マーケティングエージェントへ進化した成功事例である。その中核価値は:
優位性: - ✅ ゼロ設定18種類情報源カバー、Smart Search は完全に無料 - ✅ 関心ポイント駆動のLLM抽出、単純クローラーではない - ✅ フルチェーンコンテンツ制作:情報収集→制作→公開→レビュー - ✅ マルチエージェント協調アーキテクチャ、拡張性が強い - ✅ ローカルデプロイ、ハードウェア要件低、データ完全自主管理 - ✅ 完全オープンソース、活発なコミュニティ(8,400+ スター)
不足: - ⚠️ アンチフィンガープリントブラウザの体积が大きい、初回インストールが遅い - ⚠️ プラットフォームリスク管理は頻度制御を自分で把控 - ⚠️ Windows サポートは追加設定が必要
適用シナリオ: - 自媒体運営者:ワンストップコンテンツ制作+マルチプラットフォーム配信 - 起業家/プロダクトマネージャー:競合監視、市場インサイト - 開発者:技術ニュース追跡、オープンソースプロジェクト監視 - エージェント開発者:エージェントに動的ナレッジベースを提供
推奨指数:⭐⭐⭐⭐⭐(5/5)
ゼロから情報監視とコンテンツ制作システムを構築する必要がある個人や小チームにとって、Wiseflow/小贝は現在オープンソースコミュニティで最も完全なソリューションの一つである。これは「情報はどこから来るのか」という問題を解決するだけでなく、「どのように情報から価値を生み出すのか」という問題も解決する。
よくある質問(FAQ)
1. Wiseflow と小贝の関係は?
Wiseflow はプロジェクトの元の名前(かつて「AI 首席情報官」と呼ばれていた)で、小贝(xiaobei)は現在のブランド名である。基盤コードは同じセットであり、機能は単純な情報マイニングから完全な自媒体集客インテリジェントエージェントに拡張された。GitHub リポジトリは引き続き TeamWiseFlow/wiseflow という名前である。
2. Smart Search は本当に完全に無料?
はい、Smart Search はAPI キーの設定は一切不要で、直接使用可能である。ただし、LLM 抽出機能はモデル API キーの設定が必要(例:阿里雲百炼 Token Plan、Lite版 39元/月から)。
3. 情報マイニング機能のみ使用し、コンテンツ制作は使用しないことは可能?
可能である。Wiseflow の中核情報マイニング機能は独立しており、Smart Search とデータベース保存のみを設定し、コンテンツ制作と公開機能を使用しないことができる。
4. プラットフォームリスク管理を回避するには?
- 収集頻度を制御(6時間ごとを推奨)
- 永続セッションを使用し、頻繁なログインを回避
- 単一プラットフォームを高頻度でクロールしない
- 各プラットフォームの robots.txt と利用規約を遵守
5. 既存のエージェントプロジェクトに統合可能?
可能である。Wiseflow が抽出したデータは SQLite/PostgreSQL に保存され、エージェントはデータベースを直接クエリするか、API インターフェースを通じて最新情報を取得できる。また、抽出結果をベクトルデータベースにインポートし、セマンティック検索をサポートすることも可能。