Einleitung: Warum brauchen AI Agents ein »Team-Memory«?
Falls du schon mal mit Claude Code, Cursor, OpenCode oder ähnlichen AI-Programmierwerkzeugen gearbeitet hast, kennst du das Problem sicher:
„Jedes Mal, wenn ich ein neues Gespräch starte, muss der Agent das Projekt von vorne kennenlernen. Der ganze Kontext, den wir mühsam in Dutzenden Runden aufgebaut haben – weg mit einem Neustart."
„Fünf Leute im Team, fünf verschiedene Agent-Sitzungen. Jedes Problem muss jedem einzeln erklärt werden."
Genau hier setzt TencentDB Agent Memory an – ein von Tencent Cloud open-source veröffentlichtes Projekt. Auf GitHub hat es bereits über 10.800 Sterne gesammelt und wächst täglich um 600+ dazu. Es ist damit eines der am schnellsten wachsenden AI-Agent-Infrastrukturprojekte in der Open-Source-Community.
Was löst dieses Projekt?
Herkömmliches RAG (Retrieval-Augmented Generation) beantwortet die Frage: „Was kann ich finden?" TencentDB Agent Memory geht weiter und beantwortet:
- Wer darf dieses Memory nutzen? (Berechtigungssteuerung)
- Welche Version ist die aktuelle? (Versionsverwaltung)
- Welcher Agent soll dieses Memory erhalten? (Präzise Verteilung)
Kurz gesagt: Es lässt AI-Agent-Teams so arbeiten wie menschliche Teams – mit echter Erfahrungssammlung. Frühere Arbeit muss nicht wiederholt werden. Alte Fehler müssen nicht nochmal gemacht werden.
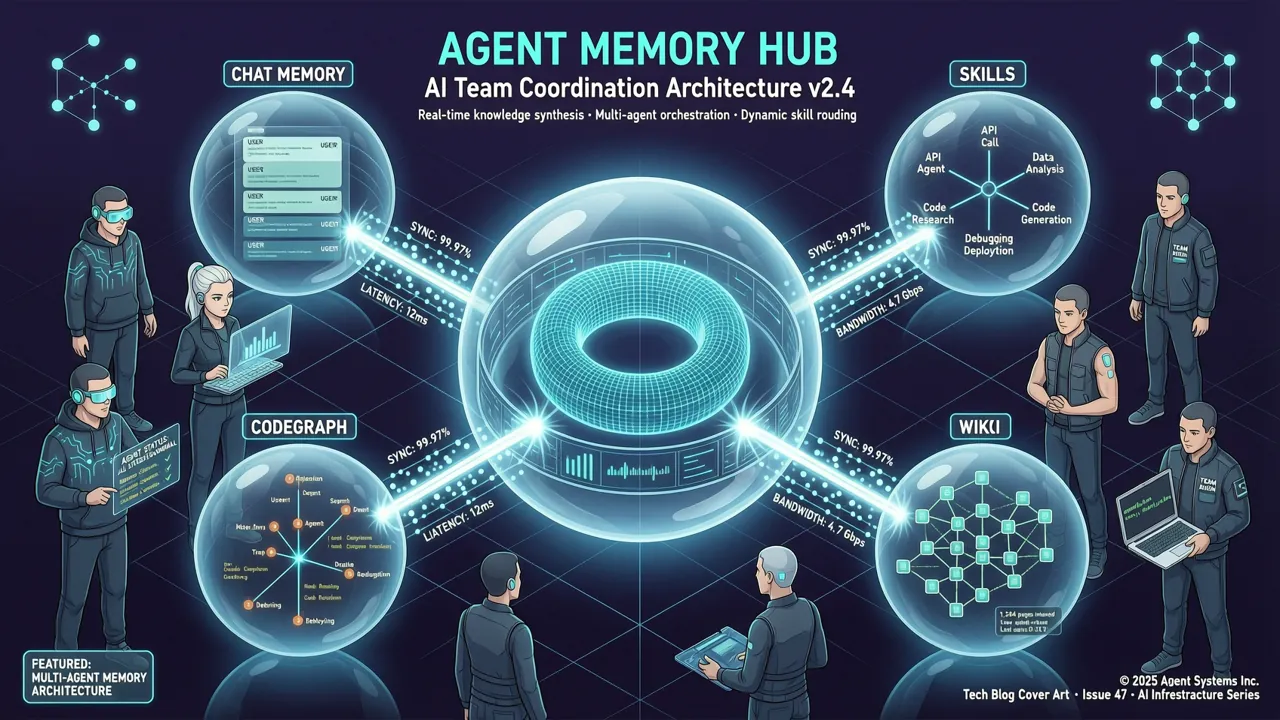
Grundkonzept: Vier Arten von Memory-Assets
TencentDB Agent Memory strukturiert Informationen in vier wiederverwendbare Memory-Assets:
1. Chat Memory (Gesprächsspeicher)
Hier werden Benutzerpräferenzen, Fakten, Entscheidungen und Interaktionsverläufe gespeichert. Nicht als simples Chat-Protokoll, sondern als strukturiertes Memory in vier Stufen:
| Stufe | Gespeicherter Inhalt | Zweck |
|---|---|---|
| L0 Conversation | Vollständiges Originalgespräch | Überprüfung, Zeitstempel, Quelle |
| L1 Atom | Extrahierte Fakten, Präferenzen, Einschränkungen | Präziser Abruf ausführbarer Informationen |
| L2 Scenario | Wissensblöcke nach Projekt/Szene sortiert | Schnelles Wiederherstellen des Arbeitskontexts |
| L3 Persona | Langfristige Profile, stabile Muster | Der Agent findet sich sofort im Teamkontext zurecht |
2. Skill (Fähigkeiten)
Skills sind wiederverwendbare Kompetenzen, die der Agent bei komplexen Aufgaben extrahiert. Es handelt sich nicht nur um Prompt-Schnipsel, sondern um vollständige Workflows mit Version, Ressourcendateien, Auslösegrenzen, Ausführungsschritten und Validierungsregeln.
- Persönliche Skills sind standardmäßig privat. Nach einer Prüfung können sie für das Team freigegeben werden.
- Beispiele: „Fehlerdiagnose-Prozess", „Code-Review-Checkliste", „Release-Checkliste". Wenn eine Person es gelernt hat, kann es das gesamte Team nutzen.
3. Wiki (Wissensdatenbank)
Produktdokumentation, Designspezifikationen und Betriebshandbücher werden in strukturierte Seiten umgewandelt – mit verknüpfter Navigation (inspiriert von Karpathys LLM-Wissensdatenbank-Konzept).
- Der Agent muss nicht jedes Mal die gesamte Dateiliste neu einlesen.
- Unterstützt hybride Suche: BM25 + Vektorsuche + RRF.
4. CodeGraph (Code-Graph)
Indiziert Code-Symbole, Dateien, Aufrufbeziehungen und Abhängigkeitspfade.
- Der Agent kann suchen, lesen, Aufrufer/Aufgerufene prüfen.
- Vor Code-Änderungen wird eine Impact-Analyse durchgeführt: „Was könnte diese Änderung alles beeinflussen?"
- Nicht nur „Hier ist der Code", sondern auch „Das passiert, wenn du ihn änderst."
Installation und Deployment
Systemanforderungen
- Linux / macOS
- Docker + Docker Compose
- Mindestens 8 GB RAM
- Zwei Sätze von LLM-API-Schlüsseln (Memory-Gruppe und Proxy-Gruppe)
Schnellstart (One-Click)
# 1. Repository klonen
git clone https://github.com/TencentCloud/TencentDB-Agent-Memory.git
cd TencentDB-Agent-Memory/deploy/global-images

# 2. Umgebungsvariablen konfigurieren
cp .env.example .env
# Bearbeite die .env-Datei und trage beide LLM-Parameter-Sätze ein:
# - Memory-Gruppe: für Memory-Extraktion und Schichtung
# - Proxy-Gruppe: für Agent-Proxy-Anfragen

# 3. Alle Dienste mit einem Befehl starten (memory-core + memory-hub + proxy)
./start-all.sh
Nach dem Start gibt das Skript einen fertigen Konfigurationsbefehl aus, den du direkt in Claude Code einfügen kannst.
Dashboard-Zugriff
# Im Browser öffnen
http://localhost:8125
Im Dashboard kannst du: - Teams und Agents erstellen - Memory-Assets durchsuchen, prüfen und verwalten - Verschiedene Memory-Assets an unterschiedliche Agents binden
Dienste stoppen
./stop-all.sh
Praxis: Baue dein Agent-Team
Angenommen, du hast ein kleines Entwicklerteam. So könntest du es aufbauen:
Tiny Inc.
├── 👤 Du          — Ziele setzen / Entscheidungen treffen
├── 🔭 Scout       — Recherchieren / Chancen finden
├── 🛠 Builder      — Code schreiben / Produkt bauen
├── 🧪 Reviewer     — Testen / Probleme finden
└── 🧠 Agent Memory — Team-Erfahrung speichern
Schritt 1: Team und Agents erstellen
Erstelle im Memory Hub Dashboard zuerst dein Team. Danach legst du für jede Rolle einen eigenen Agent an.
Schritt 2: Bestehende Assets importieren
# Bestehende Codebase importieren → CodeGraph indiziert automatisch
# Dokumentdateien importieren → Wiki wird automatisch strukturiert
# Alte Gespräche importieren → Skills und Chat Memory werden automatisch extrahiert
Schritt 3: Memory-Assets den Agents zuordnen
Verschiedene Rollen, verschiedene Ausrüstung:
🔭 Scout
 ├── User-Interview Chat Memory
 ├── Marktanalyse Wiki
 └── Wettbewerbsanalyse Skill

🛠 Builder
 ├── Produkt-Wiki
 ├── Projekt-CodeGraph
 └── Feature-Delivery Skill

🧪 Reviewer
 ├── Ereignisverlauf Chat Memory
 ├── Projekt-CodeGraph
 └── Release-Check Skill
Jeder Agent bekommt nur die Memory-Assets, die er für seine Arbeit wirklich braucht. Das reduziert Rauschen.
Fortgeschritten: API-Integration in deinen Workflow
TencentDB Agent Memory bietet eine RESTful-API zur Integration in Agent-Frameworks wie Claude Code, OpenCode oder Cursor.
Verfügbare Tools auflisten
# Welche Memory-Tools stehen dem Agent zur Verfügung?
curl http://localhost:8125/v3/tools/list
Beispiel-Antwort:
{
  "tools": [
    {
      "name": "search_memory",
      "description": "Memory-Assets durchsuchen, passende Ergebnisse zurückgeben"
    },
    {
      "name": "read_wiki",
      "description": "Wiki-Seiteninhalt lesen"
    },
    {
      "name": "inspect_codegraph",
      "description": "Code-Aufrufbeziehungen und Impact-Pfade prüfen"
    }
  ]
}
Memory-Suche aufrufen
curl -X POST http://localhost:8125/v3/tools/call \
  -H "Content-Type: application/json" \
  -d '{
    "tool": "search_memory",
    "query": "auth-Modul mobile Kompatibilität",
    "limit": 5
  }'
Integration mit Claude Code
Nach dem Start mit start-all.sh wird ein Claude-Code-Konfigurationsbefehl ausgegeben. Das Format sieht ungefähr so aus:
claude --permission-prompt-yolo \
  --tools memory-search,memory-read \
  --memory-endpoint http://localhost:8125
Damit kann Claude Code beim Programmieren automatisch auf das Wiki und den CodeGraph des Projekts zugreifen – ohne dass du den Kontext jedes Mal neu erklären musst.
Berechtigungs- und Datenschutzmodell
Das Berechtigungssystem von TencentDB Agent Memory ist sorgfältig durchdacht. Memory-Assets werden nicht einfach wahllos weitergegeben:
| Sichtbarkeit | Bedeutung |
|---|---|
private |
Nur für den Owner sichtbar – selbst Team-Admins nicht |
team |
Team-Mitglieder können lesen, Owner/Admin verwalten |
restricted |
Präzise Berechtigung über User / Role / Agent ACL |
agent |
Gezielte Ausrüstung für bestimmte Agents im Team |
Neu erstellte Chat Memories und Skills sind standardmäßig private. Freigabe ist eine explizite Aktion, kein automatisches Durchsickern.
Vergleich mit herkömmlichen RAG-Lösungen
| Fähigkeit | Standard-RAG | TencentDB Agent Memory |
|---|---|---|
| Nutzerverständnis über Sitzungen hinweg | △ | ✅ Chat Memory |
| Ausführbare Erfahrung extrahieren | — | ✅ Skill |
| Dokumentstruktur-Beziehungen | △ Chunk-Suche | ✅ Wiki + Link Graph |
| Code-Aufrufgraph & Impact-Bereich | △ Text-Matching | ✅ CodeGraph |
| Eigentum / Version / Status | — | ✅ |
| Team-Sharing & Agent-Ausrüstung | — | ✅ |
| Private / Team / ACL-Berechtigungen | △ | ✅ |
RAG löst das Problem „Wie finde ich etwas in großen Datenmengen?" Agent Memory löst das Problem „Wie bewahren wir wertvolle Erfahrungen auf und verteilen sie präzise an die Menschen und Agents, die sie brauchen?"
Häufig gestellte Fragen
F: Welche LLM-API-Schlüssel brauche ich?
Du benötigst zwei Sätze von LLM-Parametern: - Memory-Gruppe: für Gesprächsschichtung, Skill-Extraktion, Wiki-Generierung - Proxy-Gruppe: für das Weiterleiten von Agent-Proxy-Anfragen
Unterstützt werden große LLM-Anbieter (OpenAI, Anthropic, DeepSeek usw.).
F: Kann ich Daten aus älteren Versionen migrieren?
Ja. Das Projekt bietet ein Migrations-Tool:
# v2 → v3 Datenmigration
# Siehe MemoryCore/scripts/migrate-v2-to-v3/README.md
F: Welche Programmiersprachen unterstützt CodeGraph?
Der Schwerpunkt liegt aktuell auf gängigen Programmiersprachen. Die Indexierung erfolgt über HTTPS-Repositories. Lokale Repository-Unterstützung ist in Entwicklung.
F: Belegen die Memory-Assets zu viel Kontextfenster?
Nein. Die Suchergebnisse unterliegen einer dreifachen Begrenzung: Anzahl, Zeichenbudget und Timeout. Das verhindert, dass der Kontext mit Memory-Daten überflutet wird. In der Regel liefern L2/L3 eine schnelle Kontextführung. Konkrete Fakten werden bei Bedarf aus L1/L0 nachgeladen.
Fazit
Die Kernidee von TencentDB Agent Memory ist schlicht, aber wirkungsvoll:
„Die Kosten, die du in das Verstehen eines Projektkontexts investiert hast, sollten nicht von jedem neuen Agent neu bezahlt werden müssen."
Es ist kein weiteres RAG-Tool und auch kein simples Gesprächsprotokoll. Es löst das praktischste Problem bei der AI-Agent-Zusammenarbeit – wie man Erfahrung weitergibt.
- Wertvolle Interaktionen bleiben im Chat Memory erhalten.
- Bewährte Workflows werden als Skills extrahiert.
- Dokument- und Code-Änderungen werden über Wiki und CodeGraph kontinuierlich aktualisiert.
Das Projekt ist unter der MIT-Lizenz open-source verfügbar – geeignet für einzelne Entwickler und Teams. Wenn du mit mehreren AI Agents gemeinsam an Projekten arbeitest, könnte dieses Tool deine Produktivität spürbar steigern.
🔗 Verwandte Links: - GitHub: TencentCloud/TencentDB-Agent-Memory - Installationsanleitung: INSTALL.md - Chinesische Installationsanleitung: INSTALL_CN.md