引言:為什麼 AI Agent 需要「團隊記憶」?
如果你用過 Claude Code、Cursor、OpenCode 等 AI 程式設計工具,一定遇到過這樣的痛點:
「每次開新對話,Agent 都得重新了解專案背景。之前花了幾十輪對話才建立的项目上下文,一重新整理就沒了。」
「團隊裡五個人用五個不同的 Agent 對話,同樣的問題每個人都要解釋一遍。」
這正是騰訊雲開源的 TencentDB Agent Memory 要解決的核心問題。這個專案在 GitHub 上已獲得超過 10,800 顆 Star,日均增長 600+,是目前開源社群增長最快的 AI Agent 基礎設施專案之一。
它解決什麼問題?
傳統 RAG(檢索增強生成)回答的是「能找到什麼」,而 TencentDB Agent Memory 進一步回答:
- 誰可以使用這段記憶?(權限控制)
- 哪個版本是有效的?(版本管理)
- 哪個 Agent 應該接收這段記憶?(精準分發)
簡單來說,它讓 AI Agent 團隊像人類團隊一樣擁有「經驗累積」——之前做過的工作不用重來,踩過的坑不用重踩。
核心概念:四種記憶資產
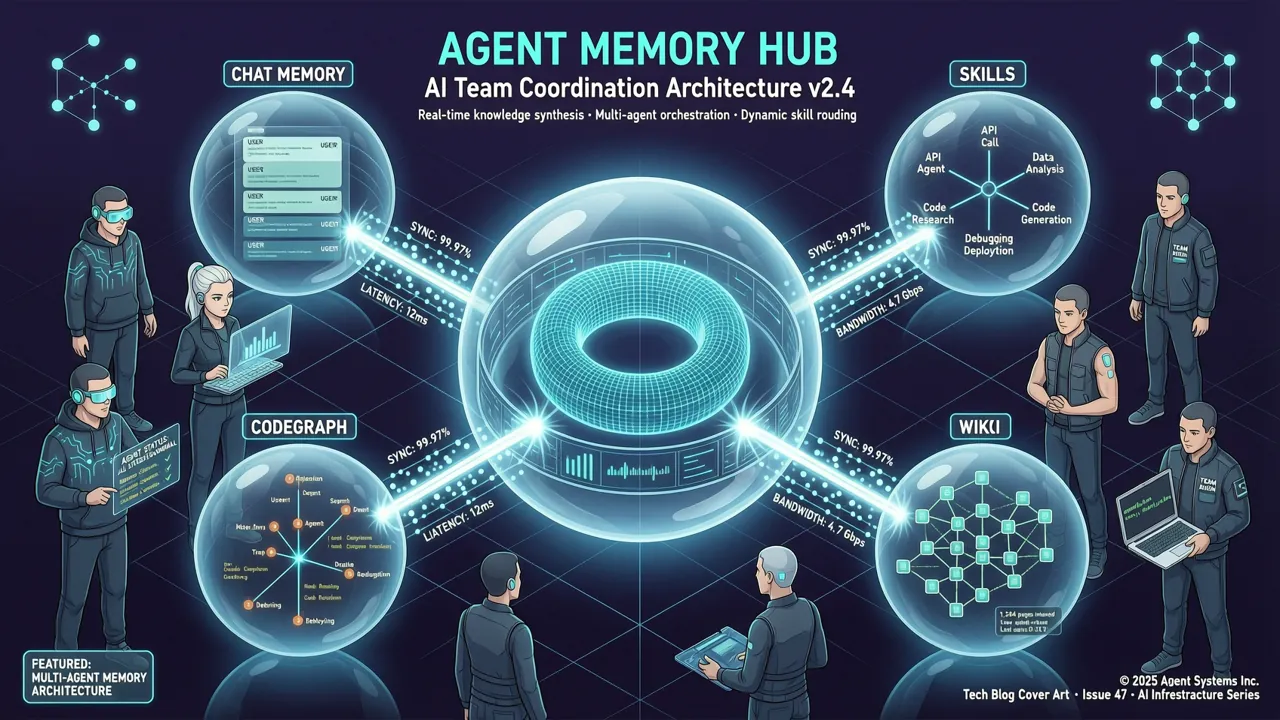
TencentDB Agent Memory 將資訊轉化為四種可複用的記憶資產(Memory Assets):
1. Chat Memory(對話記憶)
保留使用者偏好、事實、決策和互動歷史。不是簡單的聊天記錄存檔,而是經過四層提煉的結構化記憶:
| 層級 | 儲存內容 | 用途 |
|---|---|---|
| L0 Conversation | 原始完整對話 | 核實原文、時間戳記、來源 |
| L1 Atom | 從對話中提取的事實、偏好、限制 | 精準回憶可執行資訊 |
| L2 Scenario | 按專案/場景組織的知識塊 | 快速恢復工作上下文 |
| L3 Persona | 長期畫像、穩定模式 | 讓 Agent 快速進入團隊上下文 |
2. Skill(技能)
Agent 在複雜工作中提取的可複用技能——不只是 prompt 片段,而是包含版本、資源檔案、觸發邊界、執行步驟和驗證規則的完整工作流程。
- 個人 Skill 預設私有,經審核後可共享給團隊
- 比如「故障排查流程」、「程式碼審查清單」、「發佈檢查表」——一個人學會了,整個團隊都能用
3. Wiki(知識庫)
將產品文件、設計規格、維運手冊轉化為結構化頁面,支援連結圖下鑽(受 Karpathy 的 LLM 知識庫啟發)。
- Agent 不用每次工作都重新讀取整個檔案列表
- 支援 BM25 + 向量檢索 + RRF 的混合檢索
4. CodeGraph(程式碼圖譜)
索引程式碼符號、檔案、呼叫關係和影響路徑。
- Agent 可以搜尋、讀取、檢查呼叫者/被呼叫者
- 修改程式碼前進行影響分析:「改這個可能影響那些」
- 不只是告訴你「程式碼在這裡」,還告訴你「改它會影響什麼」
安裝部署
環境需求
- Linux / macOS
- Docker + Docker Compose
- 至少 8GB 記憶體
- 兩組 LLM API 金鑰(Memory 組和 Proxy 組)
快速啟動(一步到位)
# 1. 複製儲存庫
git clone https://github.com/TencentCloud/TencentDB-Agent-Memory.git
cd TencentDB-Agent-Memory/deploy/global-images

# 2. 設定環境變數
cp .env.example .env
# 編輯 .env 檔案,填入兩組 LLM 參數:
# - Memory 組:用於記憶提取和分層
# - Proxy 組:用於 Agent 代理請求

# 3. 一鍵啟動所有服務(memory-core + memory-hub + proxy)
./start-all.sh
啟動完成後,腳本會輸出一行可以直接貼上到 Claude Code 的設定命令。
存取控制面板
# 瀏覽器開啟
http://localhost:8125
在面板中你可以: - 建立團隊和 Agent - 瀏覽、搜尋、審查和管理記憶資產 - 為不同 Agent 綁定不同的記憶資產
停止服務
./stop-all.sh
實戰:建構你的 Agent 團隊
假設你有一個小型開發團隊,可以這樣設定:
Tiny Inc.
├── 👤 你          — 設定目標 / 做決策
├── 🔭 Scout       — 調研 / 找機會
├── 🛠 Builder      — 寫程式碼 / 做產品
├── 🧪 Reviewer     — 測試 / 找問題
└── 🧠 Agent Memory — 儲存團隊經驗
第一步:建立團隊和 Agent
在 Memory Hub 面板中建立團隊,然後為每個角色建立對應的 Agent。
第二步:匯入已有資產
# 匯入現有程式碼庫 → CodeGraph 自動索引
# 匯入文件檔案 → Wiki 自動產生結構化頁面
# 匯入歷史對話 → Skills 和 Chat Memory 自動提取
第三步:為不同 Agent 分配記憶資產
不同角色,不同裝備:
🔭 Scout
 ├── 使用者訪談 Chat Memory
 ├── 市場調研 Wiki
 └── 競品分析 Skill

🛠 Builder
 ├── 產品 Wiki
 ├── 專案 CodeGraph
 └── 功能交付 Skill

🧪 Reviewer
 ├── 歷史事件 Chat Memory
 ├── 專案 CodeGraph
 └── 發佈檢查 Skill
每個 Agent 只獲取完成工作所需的記憶,減少噪音。
進階:透過 API 整合到你的工作流程
TencentDB Agent Memory 提供 RESTful API,可以整合到 Claude Code、OpenCode、Cursor 等 Agent 框架中。
列出可用工具
# 檢視 Agent 可用的記憶工具
curl http://localhost:8125/v3/tools/list
返回結果範例:
{
  "tools": [
    {
      "name": "search_memory",
      "description": "搜尋記憶資產,返回匹配的結果"
    },
    {
      "name": "read_wiki",
      "description": "讀取 Wiki 頁面內容"
    },
    {
      "name": "inspect_codegraph",
      "description": "檢查程式碼呼叫關係和影響路徑"
    }
  ]
}
呼叫記憶檢索
curl -X POST http://localhost:8125/v3/tools/call \
  -H "Content-Type: application/json" \
  -d '{
    "tool": "search_memory",
    "query": "auth 模組行動裝置相容性",
    "limit": 5
  }'
與 Claude Code 整合
start-all.sh 啟動完成後會輸出 Claude Code 的設定命令,大致格式為:
claude --permission-prompt-yolo \
  --tools memory-search,memory-read \
  --memory-endpoint http://localhost:8125
這樣 Claude Code 在寫程式碼時就能自動存取專案的 Wiki 和 CodeGraph,不用你重複說明專案背景。
權限與隱私模型
TencentDB Agent Memory 的權限設計非常細緻,確保記憶資產不會隨意洩漏:
| 可見性 | 語意 |
|---|---|
private |
僅 Owner 可見——團隊管理員也不可見 |
team |
團隊成員可讀,Owner/Admin 可管理 |
restricted |
透過 User / Role / Agent ACL 精確授權 |
agent |
針對團隊內特定 Agent 的定向裝備 |
新建立的 Chat Memory 和 Skill 預設為 private,共享是顯式操作而非預設洩漏。
與傳統 RAG 方案對比
| 能力 | 標準 RAG | TencentDB Agent Memory |
|---|---|---|
| 跨對話使用者理解 | △ | ✅ Chat Memory |
| 提煉可執行經驗 | — | ✅ Skill |
| 文件結構關係 | △ Chunk 檢索 | ✅ Wiki + Link Graph |
| 程式碼呼叫圖 & 影響範圍 | △ 文字匹配 | ✅ CodeGraph |
| 所有權/版本/狀態 | — | ✅ |
| 團隊共享 & Agent 裝備 | — | ✅ |
| 私有/團隊/ACL 權限 | △ | ✅ |
RAG 解決的是「從海量資料中檢索」,而 Agent Memory 解決的是「把有價值的經驗沉澱下來,精準分發給需要的人和 Agent」。
常見問題
Q: 需要什麼樣的 LLM API 金鑰?
需要兩組 LLM 參數: - Memory 組:用於對話分層提煉、Skill 提取、Wiki 產生 - Proxy 組:用於 Agent 代理請求轉發
支援主流 LLM 供應商(OpenAI、Anthropic、DeepSeek 等)。
Q: 可以遷移舊版本資料嗎?
可以。專案提供了遷移工具:
# v2 → v3 資料遷移
# 詳見 MemoryCore/scripts/migrate-v2-to-v3/README.md
Q: CodeGraph 支援哪些語言?
目前優先支援主流程式語言,透過 HTTPS 儲存庫索引。本機儲存庫支援正在開發中。
Q: 記憶資產會佔用大量上下文視窗嗎?
不會。檢索結果有數量、字元預算和逾時限制三重約束,防止記憶淹沒上下文視窗。通常 L2/L3 提供快速上下文引導,需要具體事實時才回退到 L1/L0。
總結
TencentDB Agent Memory 的核心理念很樸素但深刻:
「你為學習專案上下文付出的成本,不應該被每個新 Agent 重新支付。」
它不是另一個 RAG 工具,也不是單純的對話歷史記錄。它解決的是 AI Agent 協作中最實際的痛點——經驗如何傳承。
- 有價值的互動保留在 Chat Memory 中
- 驗證過的工作流程提煉為 Skill
- 文件和程式碼的變化透過 Wiki 和 CodeGraph 持續更新
專案採用 MIT 授權開源,適合個人開發者和團隊使用。如果你正在用多個 AI Agent 協作開發專案,這個工具可能會顯著提升你的效率。
🔗 相關連結: - GitHub: TencentCloud/TencentDB-Agent-Memory - 安裝文件: INSTALL.md - 中文安裝文件: INSTALL_CN.md