イントロ:なぜ AI Agent に「チームメモリ」が必要なのか?
Claude Code、Cursor、OpenCode などの AI プログラミングツールを使ったことがある方なら、こんな悩みを抱えた経験があるはずです:
「新しいセッションを始めるたびに、Agent がプロジェクトの背景をもう一度理解しなきゃいけない。何十回ものやり取りでようやく構築したプロジェクトのコンテキストが、リロードしたら全部消えちゃう。」
「チーム5人がそれぞれ別の Agent セッションを使っている。同じことを全員に毎回説明しなきゃいけない。」
これはまさにテンセントクラウドがオープンソース化した TencentDB Agent Memory が解決しようとしている核心的な課題です。このプロジェクトは GitHub で 10,800 個以上の Star を獲得しており、1日あたり 600 以上増加中。現在オープンソースコミュニティで最も成長速度が速い AI Agent インフラプロジェクトの一つです。
何を解決するのか?
従来の RAG(検索拡張生成)が「何が見つかるか」に答えるのに対し、TencentDB Agent Memory はさらに次の問いに答えます:
- 誰がこの記憶を使えるのか?(権限制御)
- どのバージョンが有効なのか?(バージョン管理)
- どの Agent がこの記憶を受け取るべきか?(正確な配信)
簡単に言えば、AI Agent チームが人間チームと同じように「経験の蓄積」を持てるようにするものです。前にやった仕事をもう一度やり直す必要がなくなり、踏んだ罠をもう一度踏む必要がなくなります。
核心概念:4種類の記憶アセット
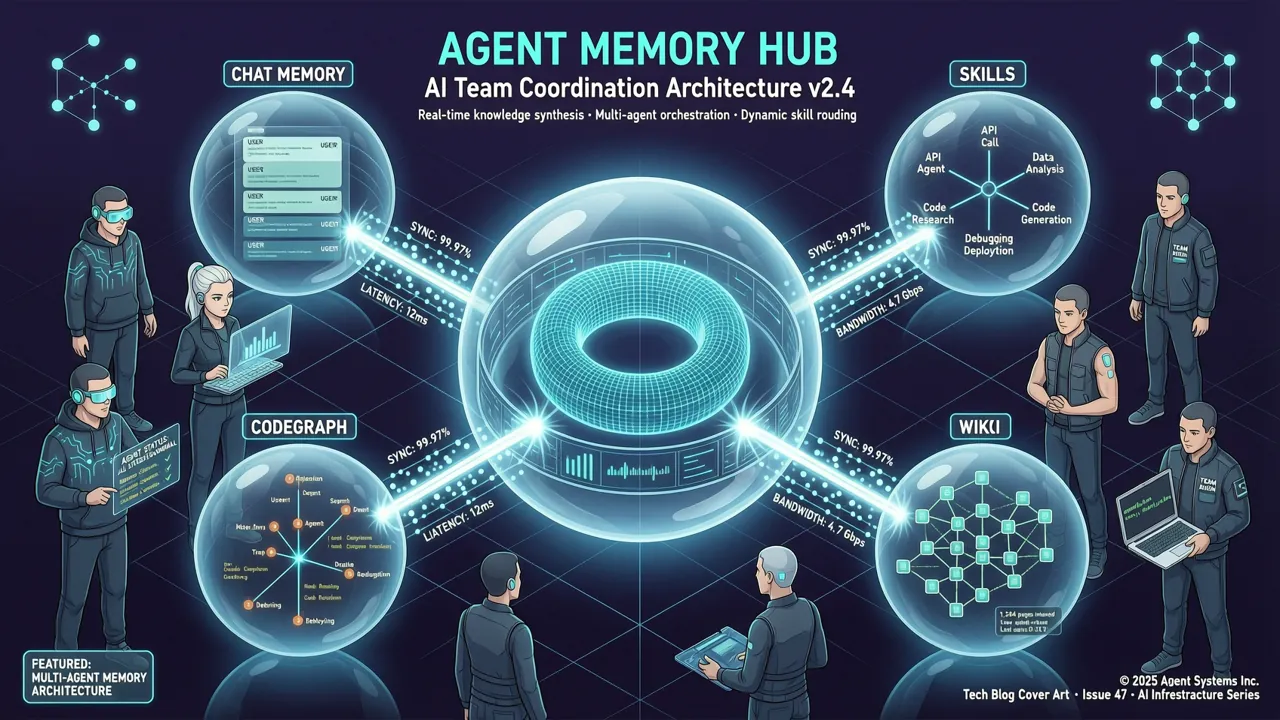
TencentDB Agent Memory は情報を4種類の再利用可能な記憶アセット(Memory Assets)に変換します:
1. Chat Memory(会話記憶)
ユーザーの好み、事実、意思決定、やり取りの履歴を保持します。単なるチャットログのアーカイブではなく、4層の提炼(精製)を経た構造化された記憶です:
| レベル | 保存内容 | 用途 |
|---|---|---|
| L0 Conversation | 元の完全な会話 | 原文の確認、タイムスタンプ、出典 |
| L1 Atom | 会話から抽出された事実・好み・制約 | 実行可能な情報を正確に記憶 |
| L2 Scenario | プロジェクト/シーン別に整理された知識ブロック | 作業コンテキストを素早く回復 |
| L3 Persona | 長期プロファイル、安定したパターン | Agent がチームコンテキストに素早く入る |
2. Skill(スキル)
Agent が複雑な作業から抽出する再利用可能なスキル。単なるプロンプトの断片ではなく、バージョン、リソースファイル、トリガーの境界、実行ステップ、検証ルールを含む完全なワークフローです。
- 個人の Skill はデフォルトでプライベート。レビュー後にチームと共有可能
- 例えば「障害トラブルシューティングフロー」「コードレビューチェックリスト」「リリース確認表」—— 一人が覚えれば、チーム全員が使える
3. Wiki(知識ベース)
製品ドキュメント、設計仕様、運用マニュアルを構造化されたページに変換します。リンクグラフによる下掘れ探索をサポート(Karpathy の LLM 知識ベースにインスパイア)。
- Agent が作業のたびにファイルリスト全体を読み直す必要がなくなる
- BM25 + ベクトル検索 + RRF のハイブリッド検索をサポート
4. CodeGraph(コードグラフ)
コードシンボル、ファイル、呼び出し関係、影響経路をインデックス化します。
- Agent が検索・読み取り・呼び出し元/呼び出し先の確認が可能
- コード変更前に影響分析:「これを変えると何に影響するか」
- 単に「コードがここにある」だけでなく、「変えると何に影響するか」も教えてくれる
インストール・デプロイメント
環境要件
- Linux / macOS
- Docker + Docker Compose
- 最低 8GB メモリ
- 2組の LLM API キー(Memory 組と Proxy 組)
クイックスタート(一括セットアップ)
# 1. リポジトリをクローン
git clone https://github.com/TencentCloud/TencentDB-Agent-Memory.git
cd TencentDB-Agent-Memory/deploy/global-images

# 2. 環境変数を設定
cp .env.example .env
# .env ファイルを編集し、2組の LLM パラメータを入力:
# - Memory 組:記憶の抽出と階層化に使用
# - Proxy 組:Agent のプロキシリクエストに使用

# 3. 全サービスを一括起動(memory-core + memory-hub + proxy)
./start-all.sh
起動完了後、スクリプトが Claude Code にそのまま貼り付けられる設定コマンドを1行出力します。
コントロールパネルへのアクセス
# ブラウザで開く
http://localhost:8125
パネルでは以下の操作が可能です: - チームと Agent の作成 - 記憶アセットの閲覧・検索・レビュー・管理 - 異なる Agent に異なる記憶アセットをバインド
サービスの停止
./stop-all.sh
実践:あなたの Agent チームを構築する
小規模な開発チームを想定して、こんな感じで設定できます:
Tiny Inc.
├── 👤 あなた      — 目標設定 / 意思決定
├── 🔭 Scout       — リサーチ / 機会発見
├── 🛠 Builder      — コーディング / 製品制作
├── 🧪 Reviewer     — テスト / 問題発見
└── 🧠 Agent Memory — チーム経験の保存
ステップ1:チームと Agent の作成
Memory Hub パネルでチームを作成し、各ロールに対応する Agent を作成します。
ステップ2:既存アセットのインポート
# 既存のコードベースをインポート → CodeGraph が自動インデックス
# ドキュメントファイルをインポート → Wiki が自動で構造化ページを生成
# 過去の会話をインポート → Skills と Chat Memory が自動抽出
ステップ3:各 Agent に記憶アセットを割り当てる
ロールによって、装備は違う:
🔭 Scout
 ├── ユーザーインタビュー Chat Memory
 ├── 市場調査 Wiki
 └── 競合分析 Skill

🛠 Builder
 ├── 製品 Wiki
 ├── プロジェクト CodeGraph
 └── 機能デリバリー Skill

🧪 Reviewer
 ├── 履歴イベント Chat Memory
 ├── プロジェクト CodeGraph
 └── リリースチェック Skill
各 Agent は仕事に必要な記憶だけを取得し、ノイズを減らします。
上級:API を使ってワークフローに統合する
TencentDB Agent Memory は RESTful API を提供しており、Claude Code、OpenCode、Cursor などの Agent フレームワークに統合できます。
利用可能なツールの一覧
# Agent が利用可能な記憶ツールを表示
curl http://localhost:8125/v3/tools/list
レスポンス例:
{
  "tools": [
    {
      "name": "search_memory",
      "description": "記憶アセットを検索し、マッチした結果を返す"
    },
    {
      "name": "read_wiki",
      "description": "Wiki ページの内容を読み取る"
    },
    {
      "name": "inspect_codegraph",
      "description": "コードの呼び出し関係と影響経路を確認する"
    }
  ]
}
記憶検索の呼び出し
curl -X POST http://localhost:8125/v3/tools/call \
  -H "Content-Type: application/json" \
  -d '{
    "tool": "search_memory",
    "query": "auth モジュールのモバイル互換性",
    "limit": 5
  }'
Claude Code との統合
start-all.sh の起動完了後に Claude Code の設定コマンドが出力されます。おおよそ以下の形式です:
claude --permission-prompt-yolo \
  --tools memory-search,memory-read \
  --memory-endpoint http://localhost:8125
これで Claude Code がコーディング中にプロジェクトの Wiki や CodeGraph に自動的にアクセスでき、プロジェクトの背景を繰り返し説明する必要がなくなります。
権限・プライバシーモデル
TencentDB Agent Memory の権限設計は非常に細かく、記憶アセットが無作為に漏洩しないよう保証しています:
| 可視性 | 意味 |
|---|---|
private |
Owner のみ閲覧可能 —— チーム管理者でも不可 |
team |
チームメンバーは閲覧可能、Owner/Admin が管理 |
restricted |
User / Role / Agent ACL による正確な認可 |
agent |
チーム内の特定 Agent 向けの定向装備 |
新しく作成された Chat Memory と Skill はデフォルトで private です。共有は明示的な操作であり、デフォルトでの漏洩ではありません。
従来 RAG との比較
| 機能 | 標準 RAG | TencentDB Agent Memory |
|---|---|---|
| セッション横断のユーザー理解 | △ | ✅ Chat Memory |
| 実行可能な経験の抽出 | — | ✅ Skill |
| ドキュメント構造の関係性 | △ Chunk 検索 | ✅ Wiki + Link Graph |
| コード呼び出し図 & 影響範囲 | △ テキストマッチ | ✅ CodeGraph |
| 所有権/バージョン/ステータス | — | ✅ |
| チーム共有 & Agent 装備 | — | ✅ |
| プライベート/チーム/ACL 権限 | △ | ✅ |
RAG は「海量データからの検索」を解決しますが、Agent Memory は「価値ある経験を沉淀させ、必要な人と Agent に正確に配布する」を解決します。
よくある質問
Q: どのような LLM API キーが必要ですか?
2組の LLM パラメータが必要です: - Memory 組:会話の階層化・精製、Skill 抽出、Wiki 生成に使用 - Proxy 組:Agent のプロキシリクエスト転送に使用
主要な LLM プロバイダー(OpenAI、Anthropic、DeepSeek など)をサポートしています。
Q: 旧バージョンのデータを移行できますか?
可能です。プロジェクトにマイグレーションツールが用意されています:
# v2 → v3 データマイグレーション
# MemoryCore/scripts/migrate-v2-to-v3/README.md を参照
Q: CodeGraph はどの言語をサポートしていますか?
現在、主要なプログラミング言語を優先サポートしており、HTTPS リポジトリ経由でインデックス化します。ローカルリポジトリのサポートは開発中です。
Q: 記憶アセットは大量のコンテキストウィンドウを占有しますか?
しません。検索結果には数、文字バジェット、タイムアウト制限の三重制約があり、記憶がコンテキストウィンドウを埋め尽くすのを防ぎます。通常 L2/L3 が素早いコンテキストガイダンスを提供し、具体的な事実が必要な場合にのみ L1/L0 にフォールバックします。
まとめ
TencentDB Agent Memory の核となるアイデアは素朴でありながら深遠です:
「プロジェクトのコンテキストを理解するために払ったコストを、新しい Agent ごとに毎回支払い直す必要はない。」
これは単なる別の RAG ツールでも、ただの会話履歴ログでもありません。AI Agent コラボレーションにおいて最も実践的な課題を解決します——経験をどう継承するか。
- 価値あるやり取りは Chat Memory に保存
- 検証済みのワークフローは Skill に抽出
- ドキュメントとコードの変化は Wiki と CodeGraph で継続的に更新
プロジェクトは MIT ライセンスでオープンソース化されており、個人開発者からチームまで幅広く利用可能です。複数の AI Agent でコラボレーション開発をしているなら、このツールはあなたの効率を大幅に向上させる可能性があります。
🔗 関連リンク: - GitHub: TencentCloud/TencentDB-Agent-Memory - インストールドキュメント: INSTALL.md - 中国語インストールドキュメント: INSTALL_CN.md