서론: AI Agent에게 왜 '팀 메모리'가 필요할까?
Claude Code, Cursor, OpenCode 같은 AI 프로그래밍 도구를 써본 적이 있다면, 이런 답답함을 겪어봤을 겁니다:
"새 세션을 열 때마다 Agent가 프로젝트 맥락을 다시 이해해야 해요. 수십 턴의 대화로 만든 컨텍스트가 새로고침 한 방에 날아갑니다."
"팀원 다섯 명이 각자 다른 Agent 세션을 쓰는데, 똑같은 문제를 매번 설명해야 해요."
이게 바로 텐센트클라우드가 오픈소스로 공개한 TencentDB Agent Memory가 해결하려는 핵심 문제입니다. 이 프로젝트는 GitHub에서 10,800개가 넘는 Star를 받았고, 하루 600개 이상씩 증가 중이라 오픈소스 커뮤니티에서 가장 빠르게 성장하는 AI Agent 인프라 프로젝트 중 하나입니다.
이게 뭘 해결해주는 거죠?
기존 RAG(검색 강화 생성)가 "무엇을 찾을 수 있는가"에 답한다면, TencentDB Agent Memory는 한 걸음 더 나아갑니다:
- 누가 이 메모리를 쓸 수 있나? (권한 관리)
- 어떤 버전이 유효한가? (버전 관리)
- 어떤 Agent가 이 메모리를 받아야 하나? (정밀 배포)
간단히 말해, AI Agent 팀이 인간 팀처럼 '경험 축적'을 할 수 있게 해줍니다. 전에 했던 일을 다시 하지 않고, 이미 경험한 함정을 다시 밟지 않게 되는 거죠.
핵심 개념: 네 가지 메모리 자산
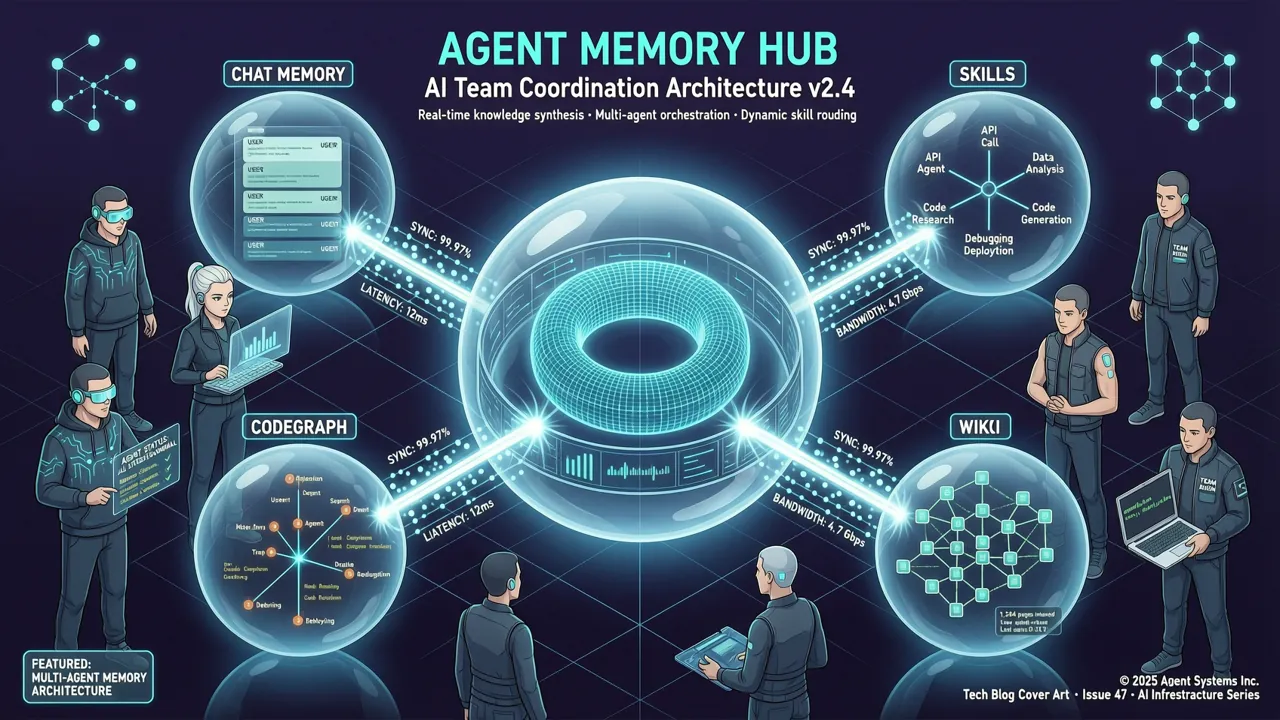
TencentDB Agent Memory는 정보를 재활용 가능한 네 가지 메모리 자산(Memory Assets)으로 전환합니다:
1. Chat Memory (대화 메모리)
사용자 선호도, 사실, 결정, 상호작용 이력을 보존합니다. 단순한 대화 로그 기록이 아니라, 4단계로 정제된 구조화된 메모리입니다:
| 레벨 | 저장 내용 | 용도 |
|---|---|---|
| L0 Conversation | 원본 전체 대화 | 원문 확인, 타임스탬프, 출처 |
| L1 Atom | 대화에서 추출한 사실, 선호도, 제약 조건 | 실행 가능한 정보를 정확히 회상 |
| L2 Scenario | 프로젝트/시나리오별 지식 블록 | 작업 컨텍스트 빠르게 복원 |
| L3 Persona | 장기 프로필, 안정적인 패턴 | Agent가 팀 컨텍스트에 빠르게 적응 |
2. Skill (스킬)
Agent가 복잡한 작업에서 추출한 재사용 가능 스킬입니다. 단순 프롬프트 조각이 아니라 버전, 리소스 파일, 트리거 경계, 실행 단계, 검증 규칙을 포함한 완전한 워크플로우입니다.
- 개인 Skill은 기본적으로 비공개이며, 검토 후 팀과 공유 가능
- 예를 들어 '장애排查流程', '코드 리뷰 체크리스트', '배포 검사표' — 한 사람이 익히면 팀 전체가 활용
3. Wiki (지식 베이스)
제품 문서, 설계 명세, 운영 매뉴얼을 구조화된 페이지로 전환합니다. 링크 그래프 드릴다운을 지원하죠(Karpathy의 LLM 지식 베이스에서 영감을 받았습니다).
- Agent가 작업할 때마다 전체 파일 목록을 다시 읽을 필요가 없음
- BM25 + 벡터 검색 + RRF의 하이브리드 검색 지원
4. CodeGraph (코드 그래프)
코드 심볼, 파일, 호출 관계, 영향 경로를 인덱싱합니다.
- Agent가 검색, 읽기, 호출자/피호출자 검사 가능
- 코드 수정 전 영향 분석: "이걸 바꾸면 어디에 영향이 갈까?"
- 단순히 "코드가 여기 있다"가 아니라 "이걸 수정하면 어떤 영향이 생긴다"까지 알려줌
설치 및 배포
환경 요구사항
- Linux / macOS
- Docker + Docker Compose
- 최소 8GB 메모리
- 두 세트의 LLM API 키 (Memory 그룹과 Proxy 그룹)
빠른 시작 (원스톱)
# 1. 레포지토리 클론
git clone https://github.com/TencentCloud/TencentDB-Agent-Memory.git
cd TencentDB-Agent-Memory/deploy/global-images

# 2. 환경 변수 설정
cp .env.example .env
# .env 파일을 편집하여 두 세트의 LLM 파라미터 입력:
# - Memory 그룹: 메모리 추출 및 계층화용
# - Proxy 그룹: Agent 프록시 요청용

# 3. 모든 서비스 원클릭 시작 (memory-core + memory-hub + proxy)
./start-all.sh
시작이 완료되면, 스크립트가 Claude Code에 바로 붙여넣을 수 있는 설정 명령을 출력합니다.
제어 패널 접근
# 브라우저에서 열기
http://localhost:8125
패널에서 다음을 할 수 있습니다: - 팀과 Agent 생성 - 메모리 자산 탐색, 검색, 검토 및 관리 - 각 Agent에 서로 다른 메모리 자산 바인딩
서비스 중지
./stop-all.sh
실전: Agent 팀 구축하기
작은 개발 팀이 있다고 가정하고, 이렇게 설정해봅시다:
Tiny Inc.
├── 👤 나          — 목표 설정 / 의사 결정
├── 🔭 Scout       — 리서치 / 기회 탐색
├── 🛠 Builder      — 코딩 / 제품 개발
├── 🧪 Reviewer     — 테스트 / 문제 발견
└── 🧠 Agent Memory — 팀 경험 저장
1단계: 팀과 Agent 생성
Memory Hub 패널에서 팀을 만든 다음, 각 역할에 맞는 Agent를 생성합니다.
2단계: 기존 자산 가져오기
# 기존 코드베이스 가져오기 → CodeGraph 자동 인덱싱
# 문서 파일 가져오기 → Wiki 자동 구조화 페이지 생성
# 이력 대화 가져오기 → Skills 및 Chat Memory 자동 추출
3단계: Agent마다 다른 메모리 자산 할당
역할이 다르면 장비도 다릅니다:
🔭 Scout
 ├── 사용자 인터뷰 Chat Memory
 ├── 시장 조사 Wiki
 └── 경쟁사 분석 Skill

🛠 Builder
 ├── 제품 Wiki
 ├── 프로젝트 CodeGraph
 └── 기능 납품 Skill

🧪 Reviewer
 ├── 이력 이벤트 Chat Memory
 ├── 프로젝트 CodeGraph
 └── 배포 검사 Skill
각 Agent는 자신의 업무에 필요한 메모리만 받아서, 노이즈를 줄입니다.
심화: API로 워크플로우에 통합하기
TencentDB Agent Memory는 RESTful API를 제공해 Claude Code, OpenCode, Cursor 같은 Agent 프레임워크에 통합할 수 있습니다.
사용 가능한 도구 목록 조회
# Agent가 사용할 수 있는 메모리 도구 확인
curl http://localhost:8125/v3/tools/list
응답 예시:
{
  "tools": [
    {
      "name": "search_memory",
      "description": "메모리 자산 검색, 매칭 결과 반환"
    },
    {
      "name": "read_wiki",
      "description": "Wiki 페이지 내용 읽기"
    },
    {
      "name": "inspect_codegraph",
      "description": "코드 호출 관계 및 영향 경로 검사"
    }
  ]
}
메모리 검색 호출
curl -X POST http://localhost:8125/v3/tools/call \
  -H "Content-Type: application/json" \
  -d '{
    "tool": "search_memory",
    "query": "auth 모듈 모바일 호환성",
    "limit": 5
  }'
Claude Code와 통합
start-all.sh 시작 완료 후 Claude Code 설정 명령이 출력됩니다. 대략 다음과 같은 형식입니다:
claude --permission-prompt-yolo \
  --tools memory-search,memory-read \
  --memory-endpoint http://localhost:8125
이렇게 하면 Claude Code가 코딩 중 프로젝트의 Wiki와 CodeGraph에 자동으로 접근할 수 있어서, 프로젝트 배경을 매번 설명하지 않아도 됩니다.
권한 및 프라이버시 모델
TencentDB Agent Memory의 권한 설계는 꽤 섬세해서, 메모리 자산이 마구 유출되지 않도록 합니다:
| 공개 범위 | 의미 |
|---|---|
private |
소유자만 열람 — 팀 관리자도 볼 수 없음 |
team |
팀원 읽기 가능, Owner/Admin 관리 가능 |
restricted |
User / Role / Agent ACL로 정밀授权 |
agent |
팀 내 특정 Agent에 대한 타겟 장비 |
새로 생성된 Chat Memory와 Skill은 기본적으로 private이며, 공유는 명시적 조작이지 기본 유출이 아닙니다.
기존 RAG 방식과 비교
| 기능 | 표준 RAG | TencentDB Agent Memory |
|---|---|---|
| 세션 간 사용자 이해 | △ | ✅ Chat Memory |
| 실행 가능한 경험 정제 | — | ✅ Skill |
| 문서 구조 관계 | △ Chunk 검색 | ✅ Wiki + Link Graph |
| 코드 호출도 및 영향 범위 | △ 텍스트 매칭 | ✅ CodeGraph |
| 소유권/버전/상태 | — | ✅ |
| 팀 공유 및 Agent 장비 | — | ✅ |
| 비공개/팀/ACL 권한 | △ | ✅ |
RAG가 "방대한 데이터에서 검색하는 것"을 해결한다면, Agent Memory는 "가치 있는 경험을 축적해, 필요한 사람과 Agent에게 정확히 배포하는 것"을 해결합니다.
자주 묻는 질문
Q: 어떤 LLM API 키가 필요한가요?
두 세트의 LLM 파라미터가 필요합니다: - Memory 그룹: 대화 계층화 정제, Skill 추출, Wiki 생성용 - Proxy 그룹: Agent 프록시 요청 전달용
주요 LLM 제공업체(OpenAI, Anthropic, DeepSeek 등)를 지원합니다.
Q: 이전 버전 데이터를 마이그레이션할 수 있나요?
가능합니다. 프로젝트에서 마이그레이션 도구를 제공합니다:
# v2 → v3 데이터 마이그레이션
# MemoryCore/scripts/migrate-v2-to-v3/README.md 참고
Q: CodeGraph는 어떤 언어를 지원하나요?
현재 주요 프로그래밍 언어를 우선 지원하며, HTTPS 레포지토리 인덱싱을 통해 접근합니다. 로컬 레포지토리 지원은 개발 중입니다.
Q: 메모리 자산이 컨텍스트 윈도우를 너무 많이 차지하진 않나요?
아니요. 검색 결과에 수량, 문자 예산, 타임아웃 제한이라는 삼중 제약이 있어서 메모리가 컨텍스트 윈도우를 덮치는 것을 방지합니다. 보통 L2/L3이 빠른 컨텍스트 가이드를 제공하고, 구체적 사실이 필요할 때만 L1/L0로 회귀합니다.
요약
TencentDB Agent Memory의 핵심 아이디어는 소박하지만 깊습니다:
"프로젝트 컨텍스트를 배우는 데 쓴 비용은, 매번 새 Agent가 다시 지불할 필요가 없어야 합니다."
이것은 또 다른 RAG 도구가 아니라, 단순 대화 이력 기록도 아닙니다. AI Agent 협업에서 가장 실제적인痛点, 즉 경험을 어떻게 전수할 것인가를 해결합니다.
- 가치 있는 상호작용은 Chat Memory에 보존
- 검증된 워크플로우는 Skill로 정제
- 문서와 코드의 변화는 Wiki와 CodeGraph를 통해 지속 업데이트
프로젝트는 MIT 라이선스로 오픈소스화되어 있어, 개인 개발자와 팀 모두 사용할 수 있습니다. 여러 AI Agent로 협업 개발 중이라면, 이 도구가 효율을 크게 높여줄 수 있습니다.
🔗 관련 링크: - GitHub: TencentCloud/TencentDB-Agent-Memory - 설치 문서: INSTALL.md - 중국어 설치 문서: INSTALL_CN.md